蚂蚁与 vLLM 社区开源 Humming:一套内核收掉量化格式碎片
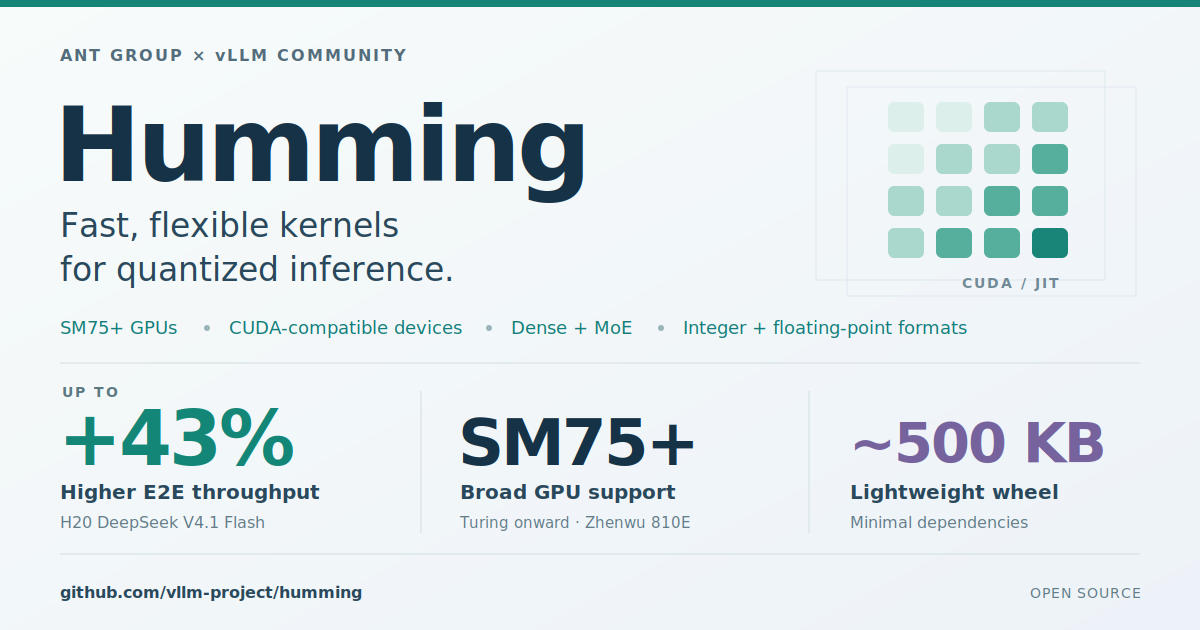
蚂蚁集团与 vLLM 社区开源 Humming,一个面向量化推理的通用 GEMM 内核库,仓库在 github.com/vllm-project/humming。它把「量化怎么描述」与「内核怎么执行」拆开:同一套架构覆盖 8 bit 以内的各种权重类型与 FP16 / BF16 / FP8 / FP4 / INT8 / INT4 激活的组合,同时支持稠密与 MoE 两类 GEMM,标称包体只有 100 多 KB、依赖只有 PyTorch 与 NVCC。
性能上给出了完整的端到端对照:在 8 张 H20、TP=8 上跑 DeepSeek-V4.1-Flash,权重保持 MXFP4 不变,仅把 MoE 执行从 vLLM Marlin W4A16(BF16 激活)换成 Humming W4A8(tokenwise FP8 激活),并发 64 时输出吞吐从 442.37 升到 633.94 tokens/s,单 token 平均耗时(TPOT)降约 31%;小中 batch 下比 DeepGEMM 快约 2.6 倍与 2.5 倍,W4A8 在 H20 约 4.2 倍、H200 约 4.5 倍于 BF16 基线,SM120 上最低位宽配置超过 BF16 cuBLAS 的 5 倍。
这件事的意义不在单点加速。量化格式与位宽组合本来就是碎片化的维护负担:每加一种组合,就要单独做权重预处理、选核、框架适配与测试。Humming 用统一表示加共享组件把这个成本压下来,并顺带把非英伟达的 CUDA 兼容设备(平头哥真武 810E)纳入同一套内核与调优流程——对以英伟达为中心的推理栈来说,这是少见的硬件横向扩展。
原文链接:vLLM 官方博客 / 蚂蚁集团
核验记录
官方博文 vllm.ai/blog/2026-10-21-humming 直读 183,208 字节,JSON-LD datePublished=2026-10-21、页内可见 October 21, 2026,两证同日。性能数字(442.37→633.94 tokens/s、TPOT -31%、2.6×/2.5× DeepGEMM、4.2×/4.5×、SM120 >5×)逐字取自博文 Results 段;「100 多 KB、仅依赖 PyTorch 与 NVCC」取自官方仓库 README。配图 og:image 裸请求与带站内 Referer 各测一次,均 200 / image/png / 94,023 字节。未逐行核对博文中的表格原始数据。