Cartesia 用字节级 H-Net 做缩放律:同算力比 BPE 高 1.3 倍
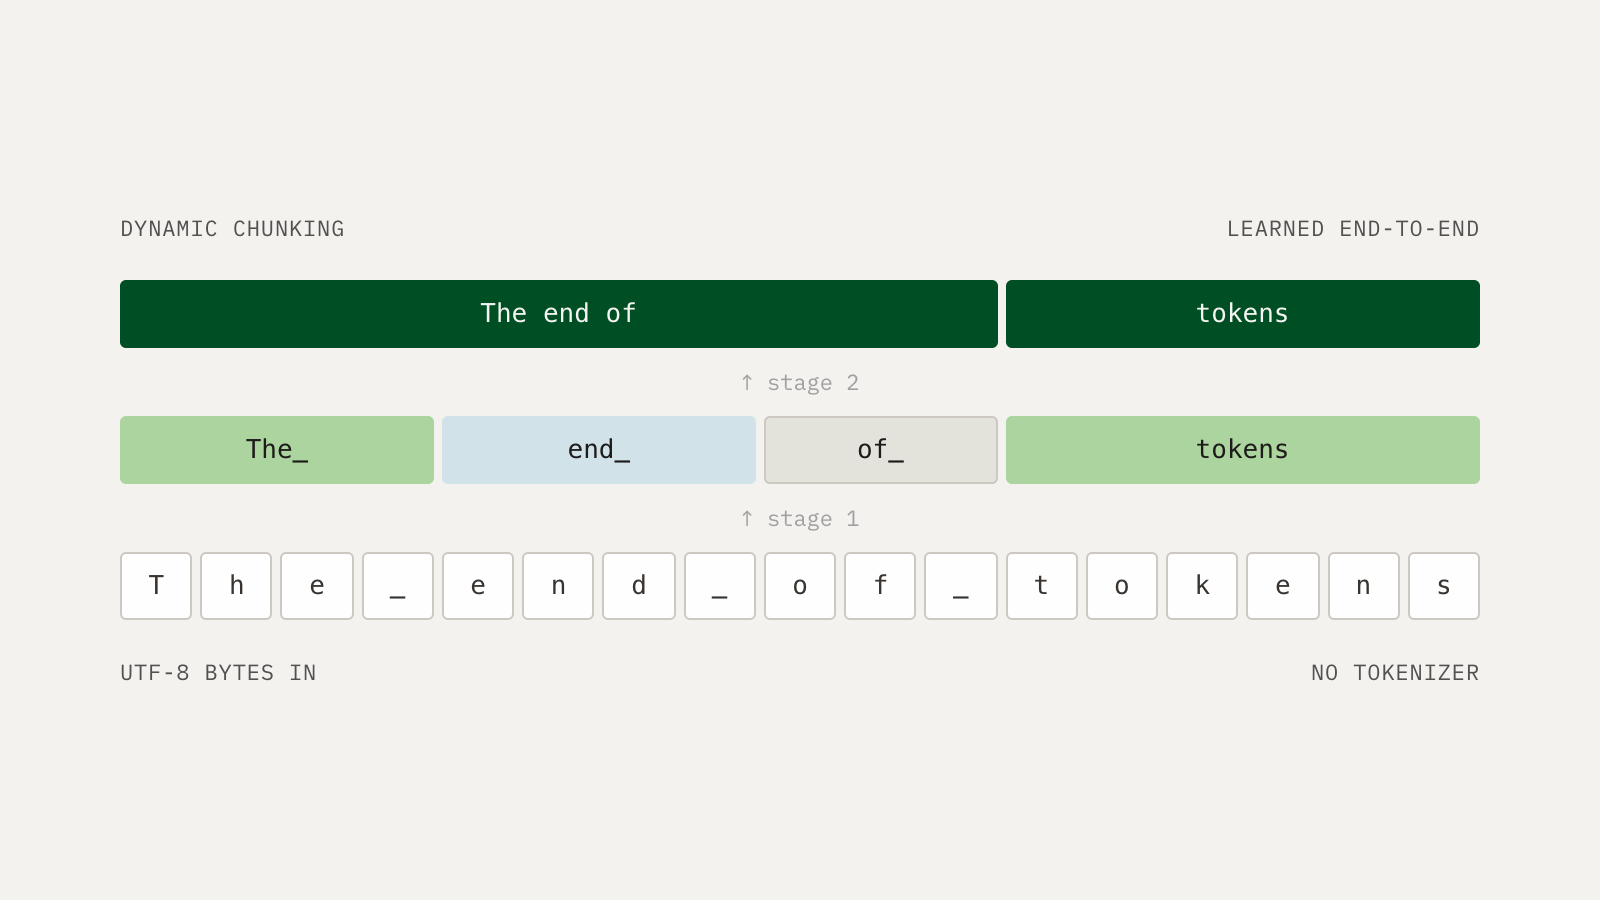
Cartesia 公开一组控制变量实验:先按文献惯例搭一条 BPE Transformer 的缩放梯,再把每一级换成字节级 H-Net(层级网络)作为即插即用替代,复用同一骨干架构与超参。数据按字节计 70% 英文 / 20% 代码 / 5% 数学 / 5% 多语;每条样本同时按字节与 BPE 切分且切点对齐在同一边界,度量统一用 bits-per-byte,避免两种分词器的刻度差把比较做歪。
只换分词组件,结果是验证损失上等价 1.3× 算力,代码子域 2×,域外评测 2×、域外代码最高 5×。为排除「拿现成分词器占便宜」,他们还用训练语料重训了一个 BPE 分词器(词表 128k、平均 token 长度从 Llama-3 的 4.45 升到 4.57),这个更强的基线本身贡献约 1.1× 算力增益——即对现成 tokenizer,H-Net 的相对优势比 1.3× 还大。
价值在于口径统一:字节级建模过去缺的正是「算力最优」这一层证据,原论文只在固定规模上调参;这次给出的是缩放梯加算力乘数,可与其它架构改动按同一把尺子比较(文中并列 Kimi Delta Attention 的 1.16×、attention residuals 的 1.25×)。局限也要说清:方法以 1.3B 级模型、100B token 档为基准,更大规模是否同斜率文中未给;权重与代码未随本文发布,属研究披露而非可用模型。
原文链接:Cartesia 官方博客
核验记录
页内 JSON-LD datePublished 2026-10-28 与可见日期 Oct 28, 2026 双证,定日取该日。1.3×/2×/5×、1.1×、词表 128k、token 长度 4.45→4.57、70/20/5/5 数据配比、bpb 度量均为原文照录。未直读其训练曲线原始数据、未复现;「更大规模未给」的判断依据是该文只列到 100B token 档,分母是本文范围而非作者全部工作。配图为官方 og webp,裸请求与带站内 Referer 双 200(12,772 字节,RIFF WebP)。
← 上一篇Samaya 发 Sterling:30B 模型后训练,金融研究 benchmark 超 Claude Fable 5.1下一篇 →Particle-1 发布:在 DeepSeek V4.1 Flash 上后训练,平均省 45% token