Figure 发 Helix 2.5:只改「有没有人类行为预训练」这一项,30 个陌生家庭的完整任务成功率从 9% 升到 56%
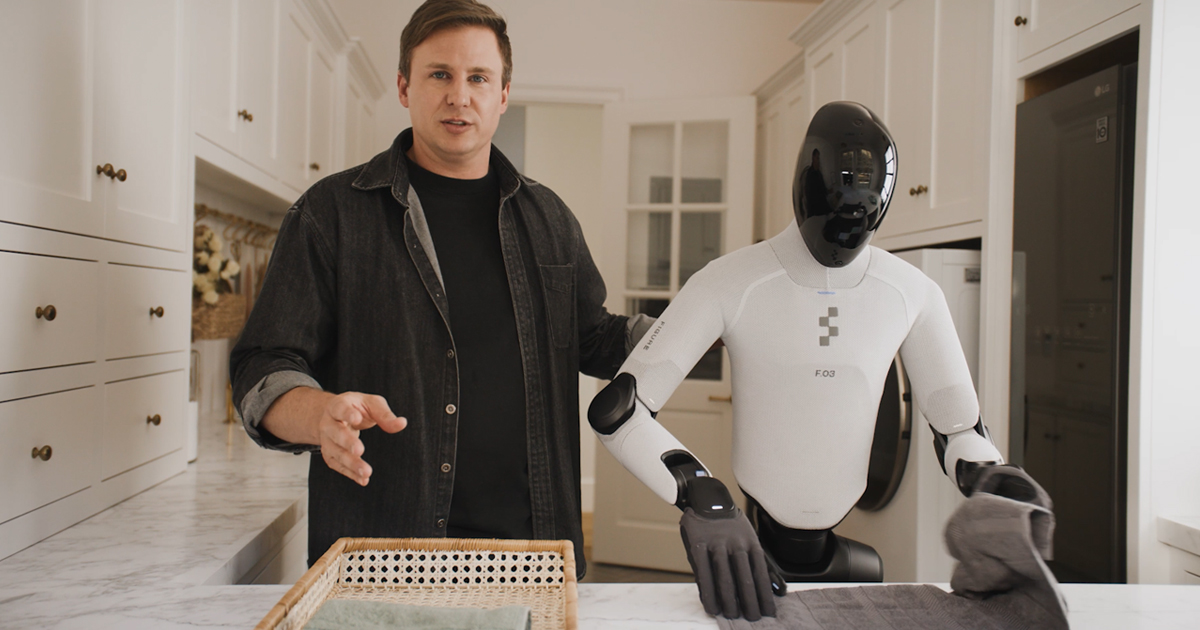
9 月 17 日,Figure 发布 Helix 2.5,称其为第一个在 30 个此前未采集任何数据的湾区家庭里完成全身长程任务的系统:收拾客厅、叠毛巾、铺床三种行为,现场不采数据、不微调、不按执行结果切换模型。它把「零样本」严格限定为「面对新的家庭布局与物体实例无需重新训练」——这三个任务此前都用其他环境采集的数据适配过。
真正有信息量的是两组对照实验。Figure 用同一批任务数据训练两套策略,架构、优化方式、超参、下游数据与评测方法全部固定,唯一差别是初始化:随机初始化的模型在 30 个陌生家庭里完整任务成功率 9%(部分完成不得分),从 Index 预训练模型出发的达到 56%。另一组把 Index 预训练数据按 1 到 8 倍做成四档嵌套子集,模型规模与下游训练不变,机器人动作预测损失随数据翻倍规律下降;官方称用较小规模拟合出的趋势去预测最大规模结果,误差只相当于整个 8 倍数据范围内损失变化的 0.54%。
它改变了什么:把「人类经验能不能像文本之于大模型那样,成为可扩展、且收益可预测的机器人预训练资产」从命题变成了带对照的工程证据,也是第一次把这条迁移曲线延伸到全身人形系统。边界要说清:9% 与 56% 都是 Figure 自报,无第三方复现;更重要的是,1、2、4、8 倍预训练各自对应的真机闭环成功率 Figure 并未公布,所以「预训练越大真机越好」这条连续曲线目前还画不出来。
原文链接:Figure AI 官方新闻室
核验记录
官方页直读 figure.ai/news/helix-2-5-zero-shot-30-home-generalization,页内可见 September 17, 2026(该页无 JSON-LD datePublished、无 article:published_time,日期取页内可见文本)。9% / 56% / 0.54% 三处数字逐字取自官方页 Key Results 段;配图取该页 og:image,裸请求与带 Referer 各测一次均 200(389,993 字节,JPEG)。量子位 9/23 12:25 现场稿(页内精确到秒)交叉,其独立澄清了「9%→56% 与 Dyna 的 20%→53% 属两组不同实验、不可直接比较」,已据此写入正文边界。未读数:Figure 未公布 1/2/4/8 倍预训练各自的真机闭环成功率;Index 数据集的绝对规模(小时数)本文未核,只核到官方口径「8 倍区间」这一相对倍数。本条目为此前多轮取景框外的漏收——Figure 不在 HF 组织白名单、无 HF 权重仓、不在任何 RSS 清单,靠厂商新闻室列表页兜出。
← 上一篇Epoch 用贸易数据估出:经马来西亚流向中国的 AI 芯片约 30 亿美元下一篇 →GPT-6 Astra 破译 1941 年德军 Enigma 密电:自 2005 年悬置,由领域权威公开验证