Fireworks 发 Ember-1:把 Kimi K3 的推理砍掉 35–50%,同质量下 token 省一半
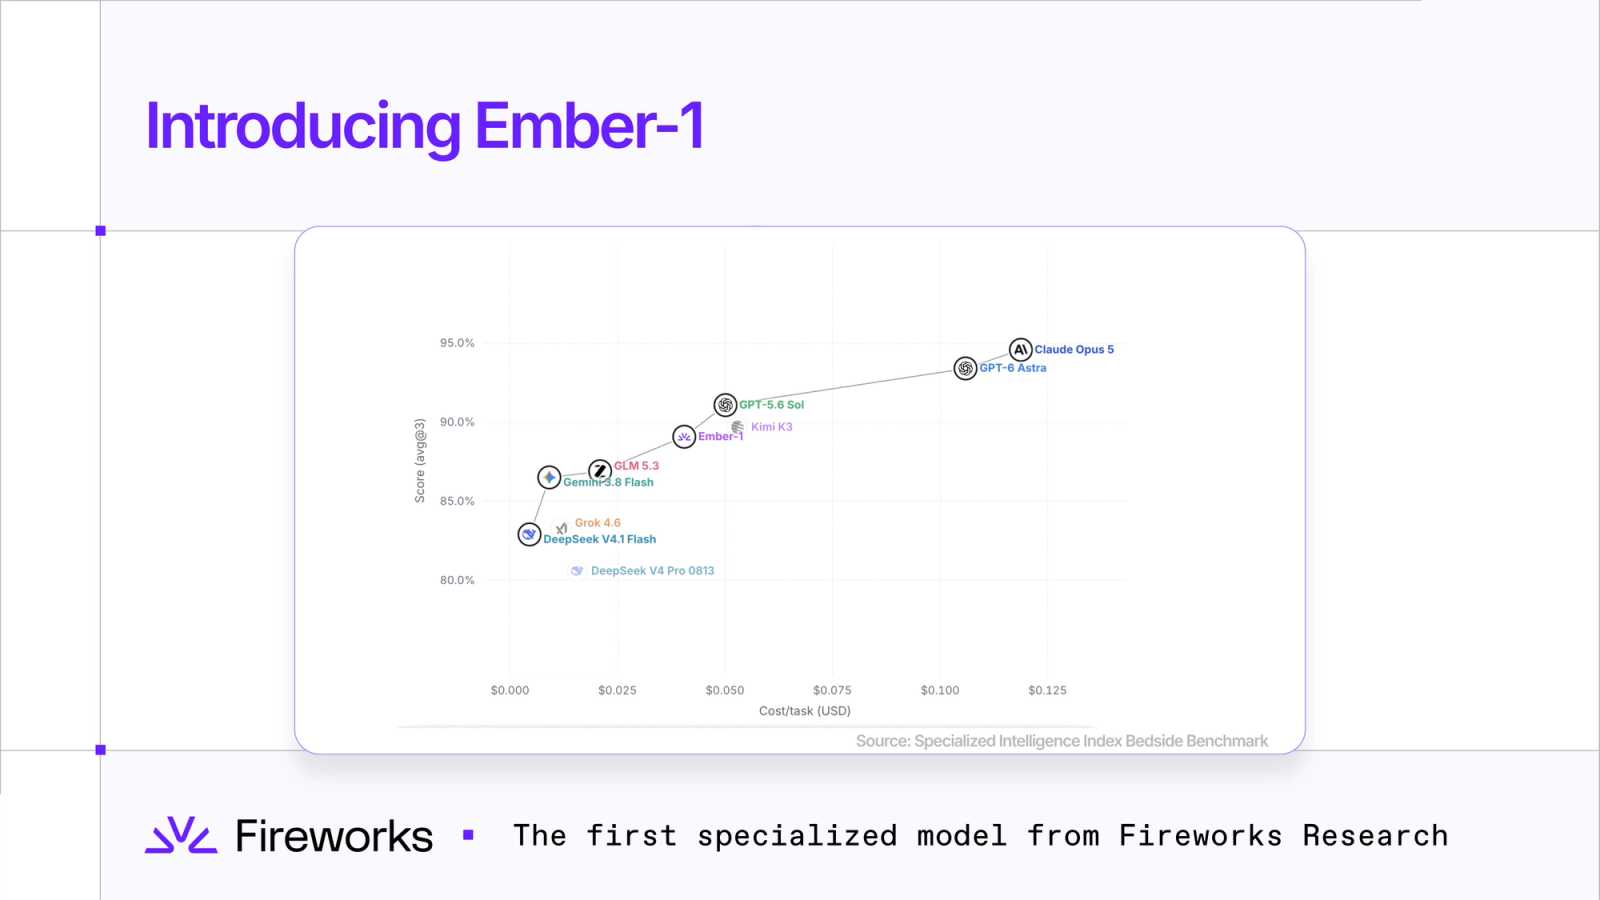
9 月 23 日,Fireworks Research 发布 Ember-1,官方口径是「Kimi K3 的质量、少 40% 的 token」:在 K3 之上做后训练,专门削掉不必要的推理,同时保住自我反思、纠错这类真正有用的思考。团队跑了 50 多个训练实验、200 多次评测,训练数据覆盖数学、编码、指令遵循、对话、检索、工具调用与软件工程,全部在自家 Serverless Training 上完成。
数字:七个公开基准加两个客户的生产流量 A/B,K3 的推理链可缩短 35–50% 而准确率不降。逐项看,Terminal-Bench 2.1 得 82.0%(K3 满档 80.9%)、DeepSWE 1.1 得 75.2%(66.4%)、SWE-bench Verified 92.2%(93.2%)、τ-2 Bench Airline 66%;按 K3 公开 API 价折算,Terminal-Bench 每条任务省 23.1 美元(降 51.9%)、DeepSWE 省 126.9 美元(降 23.7%)。
它改变了什么:过去压成本只能把推理档位调低,代价是质量下滑,Ember-1 说明「让模型学会少想」是一条独立路线。收益在多轮智能体场景被放大——每轮都要重放历史推理,上下文随轮数近似平方增长,早期多余推理会被反复重读、反复计费。同周 Fireworks 还发布 Specialized Intelligence Index,把自己从推理平台推到「专用模型厂商」的位置。
原文链接:Fireworks 官方博客
核验记录
官方博客 fireworks.ai/blog/ember-1 直读(299,199 字节),JSON-LD datePublished=2026-09-23、页内 PUBLISHED 9/23/2026 双证;OpenRouter 上 fireworks/ember-1 的 created 时间戳为 2026-09-24 00:07,两枚独立时间戳互证;基准与成本数字均为厂商自测,未做第三方复核;配图取自博客正文首图(sanity CDN,裸请求与带站内 Referer 均 200,1600×900 PNG)
← 上一篇SkillGym 把 2,756 份 Agent Skill 变成训练场:35B 模型终 Bench 2.1 涨 19.1 个百分点下一篇 →1-bit 模型进 AI 眼镜:高通与 PrismML 在骁龙 AR1 上本地跑通 2B 视觉语言模型