Interfaze 开源 Lev:4B 的 System One 决策模型,一次前向给出概率、输出零 token,13 项 S1Bench 平均 68.9%
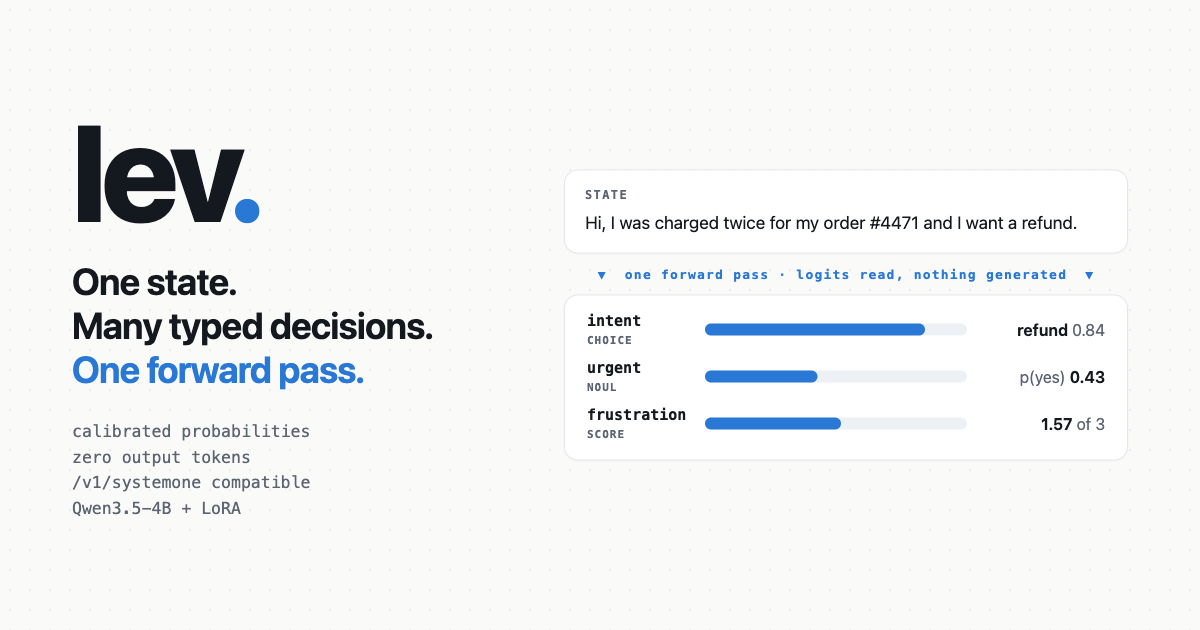
Interfaze 在 9 月 24 日的官方博客上放出 Lev,一个开源的 System One 模型,说的正是 TypeSafe AI 的 Jev 那套接口:你给它一段状态(工单、邮件、一段 JSON)和一组问题,它一次前向就把每个选项的概率读出来,不生成任何 token。问题分三类——noul 给 yes/no 概率、choice 从你给的标签里选一个、score 在 2 到 10 个有序档位里给期望档位,都带概率与置信度。权重在 Hugging Face 上以 Apache-2.0 放出,是 Qwen3.5-4B 上的一个 LoRA 适配器,代码在 GitHub。
数字是它敢公开对打的地方。官方对比表里,13 个 S1Bench 子集上 Lev 平均 68.9%,闭源的 Jev 是 76.1%;校准误差 ECE 分别是 0.115 与 0.091;选项容量上 Jev 每个 choice 上限 255 个,Lev 用标签编码后可以到几百个。体积差得更明显:Lev 是 4B(基座约 8GB,适配器约 200MB),盯的是「自己的卡上跑得起」——官方说一张 H100 测过,实际上 MacBook 或小显卡也能带。官方也划了边界:答案空间被锁死在用户给的选项集里,结构上不会返回越界标签,但选错仍可能发生,这是结构保证不是正确性保证。
它值得记的原因是这个位置本身。分类、路由、审核、意图识别、打分这类判断在一个真实产品里一天要跑几千次,用大模型做意味着要加校验、重试和人工复核队列;System One 这条线想做的事是把这些判断从「生成文本再解析」改成「读 logits 出概率」,代价是模型不再能输出选项之外的东西。Lev 把这个思路第一次以开源权重放了出来,同时把 68.9% 这个与闭源榜首的差距也一起公开了。