LiberAI 发布 Liber-0:基于 220 万小时人类经验训练的世界-动作模型
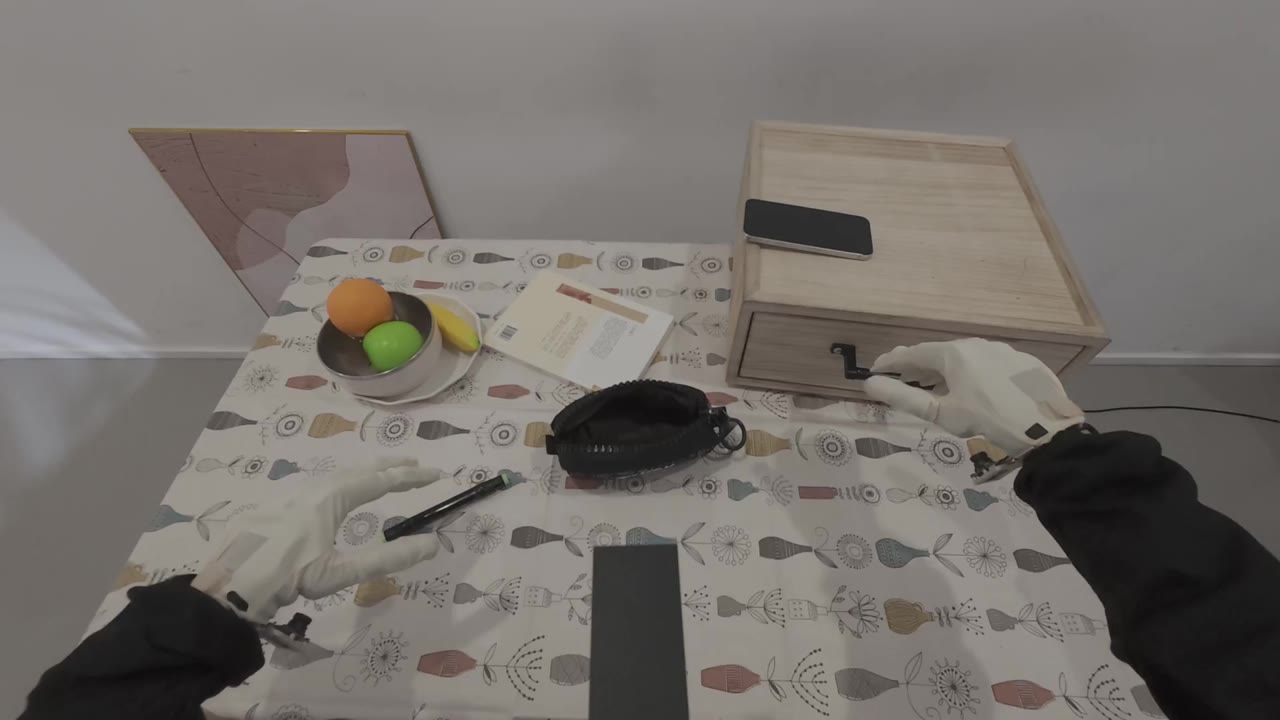
LiberAI 于 11 月 4 日正式发布 Liber-0 全版:一个世界-动作模型(World Action Model),在超过 220 万小时人类经验上预训练,通过「具身即上下文」的统一具身表示、LiberSense 手套提供的精确手部动作锚点,以及机器人观测与运动向人类演示对齐,把人类经验转化为可执行的机器人技能。
架构上采用 Mixture-of-Transformers,包含语言、视觉与动作三个专家,通过多模态注意力联合预测未来帧与动作;并辅以语义协同训练(VQA、分割、图像编辑、视频理解)以补足任务语义与空间关系理解。在 60 个未经任务特定演示的操控任务上取得 36.0% 零样本成功率(拾取放置 63.5%、其他操控 34.0%、长时序非拾取 10.5%)。
RoboDojo 仿真榜此前的 Liber-0 Preview 版(9 月 17 日登顶,平均分 30.74、成功率 25.52%)已于 9 月 17 日进入榜单;完整版 Liber-0 于 11 月 4 日正式发布(新闻稿与 roboticsandautomationnews 报道)。模型可选配 GPT-6 Astra 等推理智能体进行中间目标规划。
发布日期 11-04 取自 EIN Presswire 通稿(dateline November 4, 2026)与 roboticsandautomationnews 报道(November 4, 2026 by Sam Francis);官方博客 liberai.com/blog/liber0/ 页内未显示日期字段,配图走官方站点图(双通路 200)。此前 Preview 版的 RoboDojo 榜单条目日期为 2026-09-17(第三方榜单,非官方发布日)。置信度:中(官方通稿日期为一手,但博客页无 datePublished 字段)。
原文链接:LiberAI 官方博客