Liquid AI 给 3B 端侧 VLM 配 DSpark 草稿模型:输出不变,Apple 端解码最高快 3.13 倍
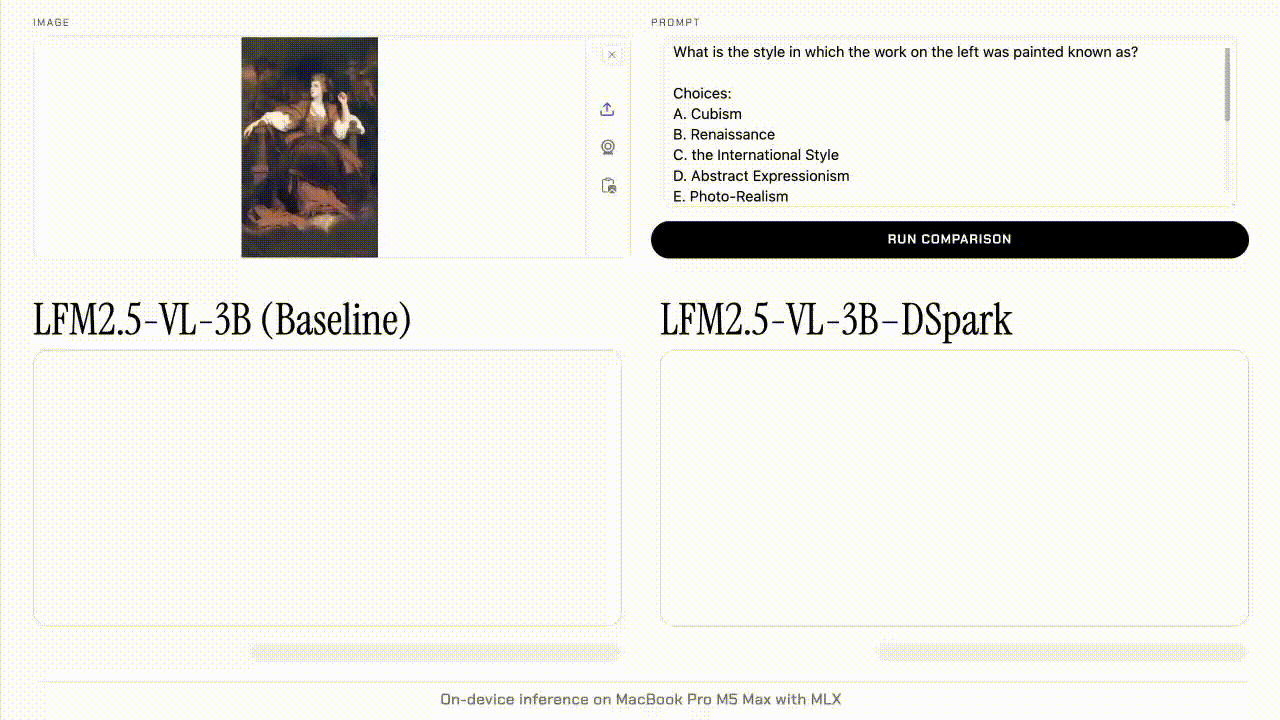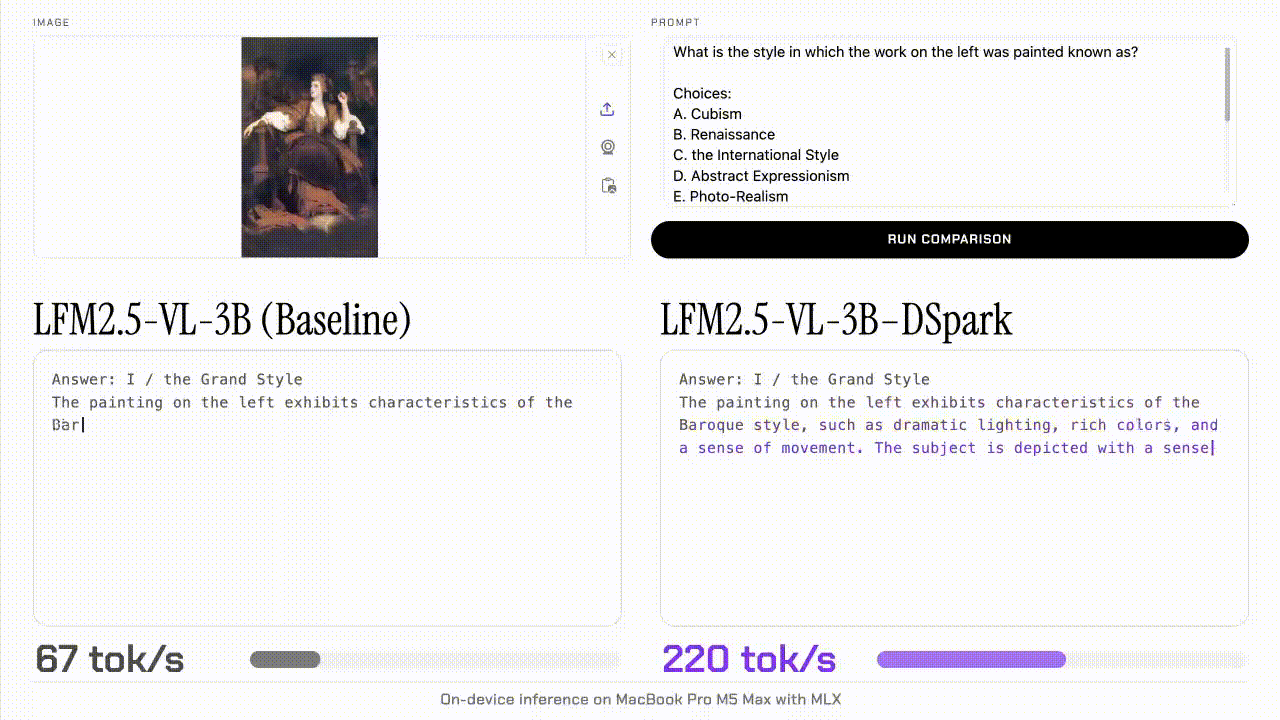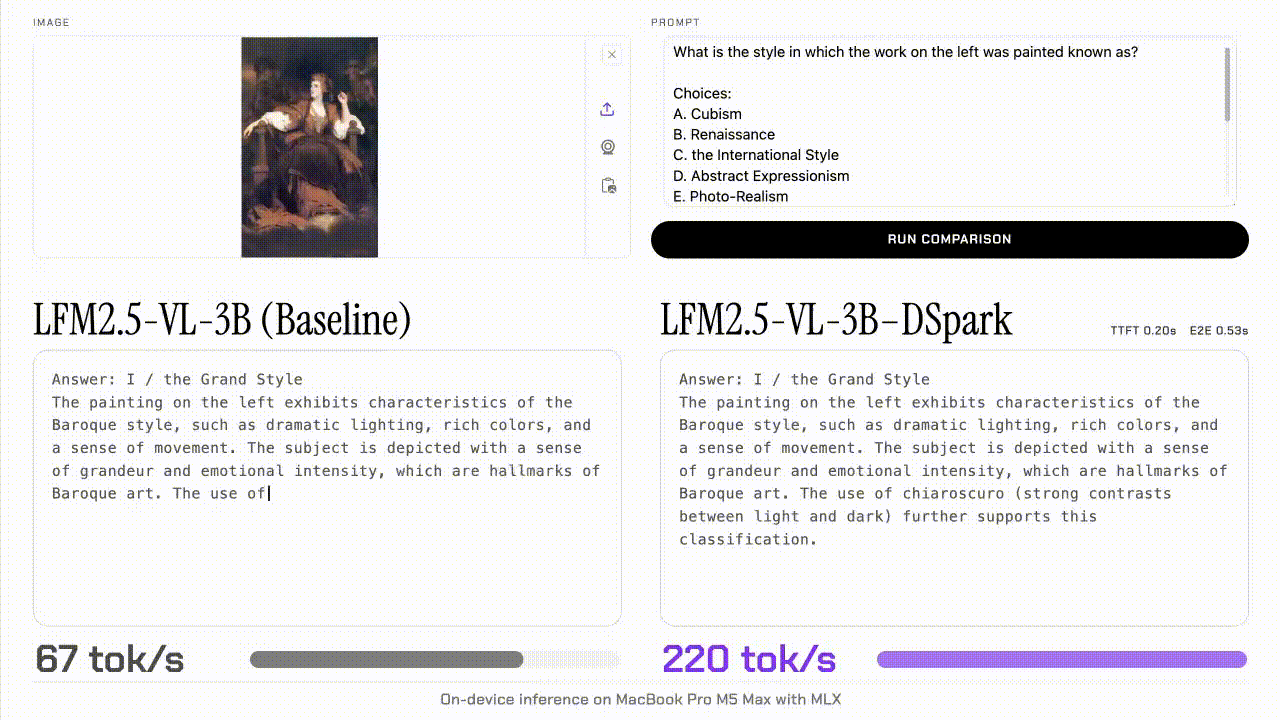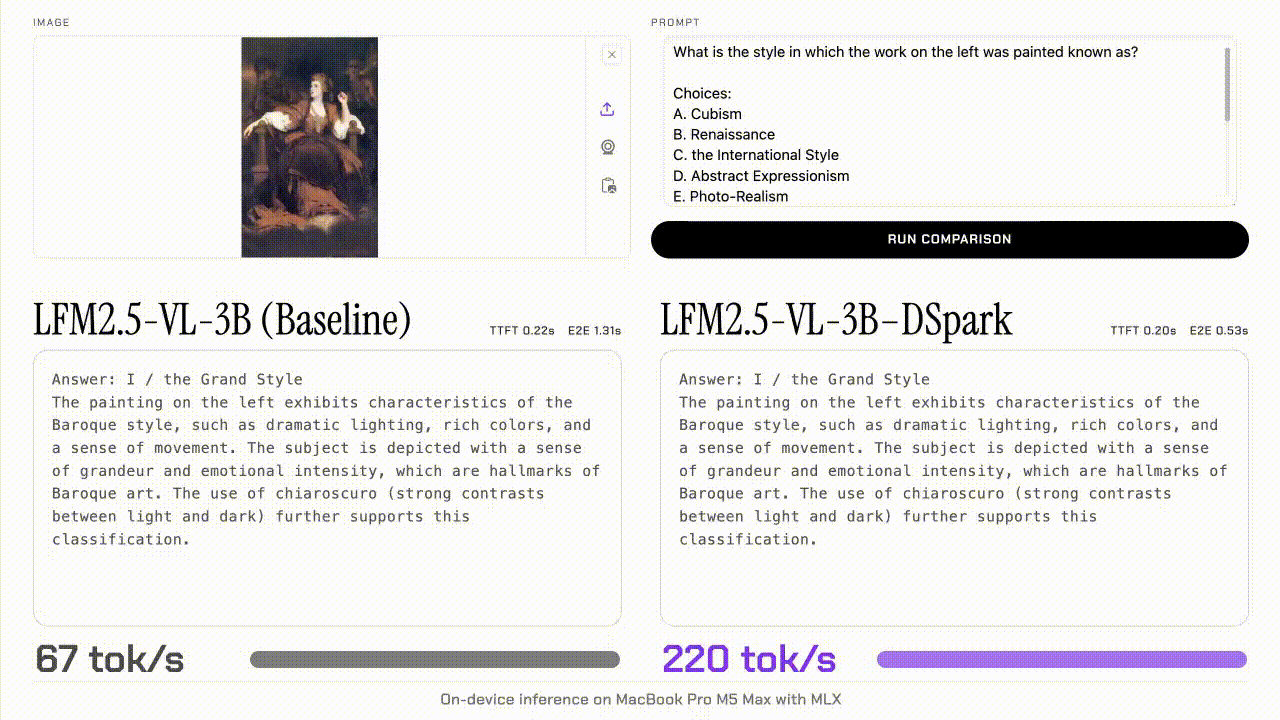
Liquid AI 发布 LFM2.5-VL-DSpark:为 3B 参数的 LFM2.5-VL-3B 视觉语言模型配套的推测解码草稿模型。它从目标模型不同层的隐藏状态推测下一组 token,再交回目标模型校验;文本和图像 patch 到隐藏层后都是同一种张量,因此同一套草稿机制可直接用于视觉语言推理。官方强调它不是新基座,输出质量与目标模型保持一致,模型仓库和 GGUF 版本均已开放。
代价与收益都很明确:草稿模型约 280M 参数,使部署模型的参数规模增加 8.9%;在单张 H100 的 SGLang 上解码最高加速 2.66 倍,在 M5 Max 的 MLX-VLM 上最高 3.13 倍、M3 Ultra 的 llama.cpp 上最高 2.14 倍。官方同时给出端到端最高 2.62 倍的收益,说明视觉输入预处理仍占一部分时间,不能把解码峰值直接当作完整任务加速。意义是端侧 VLM 第一次拿到可配套、可替换目标模型的推测解码实现:模型能力不变,减少的是逐 token 串行解码的等待。
边界:以上均为 Liquid AI 官方测试,任务分布、批大小、视觉提示长度与接受率会改变实际收益;本轮没有在 Apple Silicon 或 H100 上复跑,也没有核验不同 llama.cpp / SGLang 版本间的重复性。
核验记录
Liquid AI 官方博客直读(452,130 字节),JSON-LD datePublished、og:article:published_time、time datetime 与页内 SEP 24, 2026 四处均为 2026-09-24;HF 官方模型 API createdAt 2026-09-18T07:44Z、lastModified 2026-09-24T14:18Z。280M、8.9%、2.66×、3.13×、2.14×、2.62× 逐项取自官方正文与 HF 模型卡;厂商测试未独立复跑。
← 上一篇Google 发 CANVAS 多智能体框架:把长视频连贯性变成可闭环修正的全局问题下一篇 →谷歌开源 RRSI:给智能体「自我进化」上正则,分布外多拿 4.7 分、策略 token 省 30%