面壁开源 MiniCPM-OCR:1.3B 解析配 2B 判别器,OCR 结果能打分
面壁智能与 OpenBMB 开源 MiniCPM-OCR。主模型 1.0 为 1.3B,在 MiniCPM-V 4.6 基础上专训 OCR:视觉端是 SigLIP 编码器配 LLaVA-UHD v4 切片——高清图按 448×448 分片、再叠一张低分辨率概览图,最多 9 片,视觉 token 在 ViT 内部先压 4 倍;语言端是 Qwen3.5。另有自适应上采样与自动纠偏,倒置、旋转的翻拍件不必人工预处理。Apache-2.0 权重、pip SDK、API 与在线 Demo 同日可用,vLLM、SGLang、llama.cpp、Ollama 首日适配。
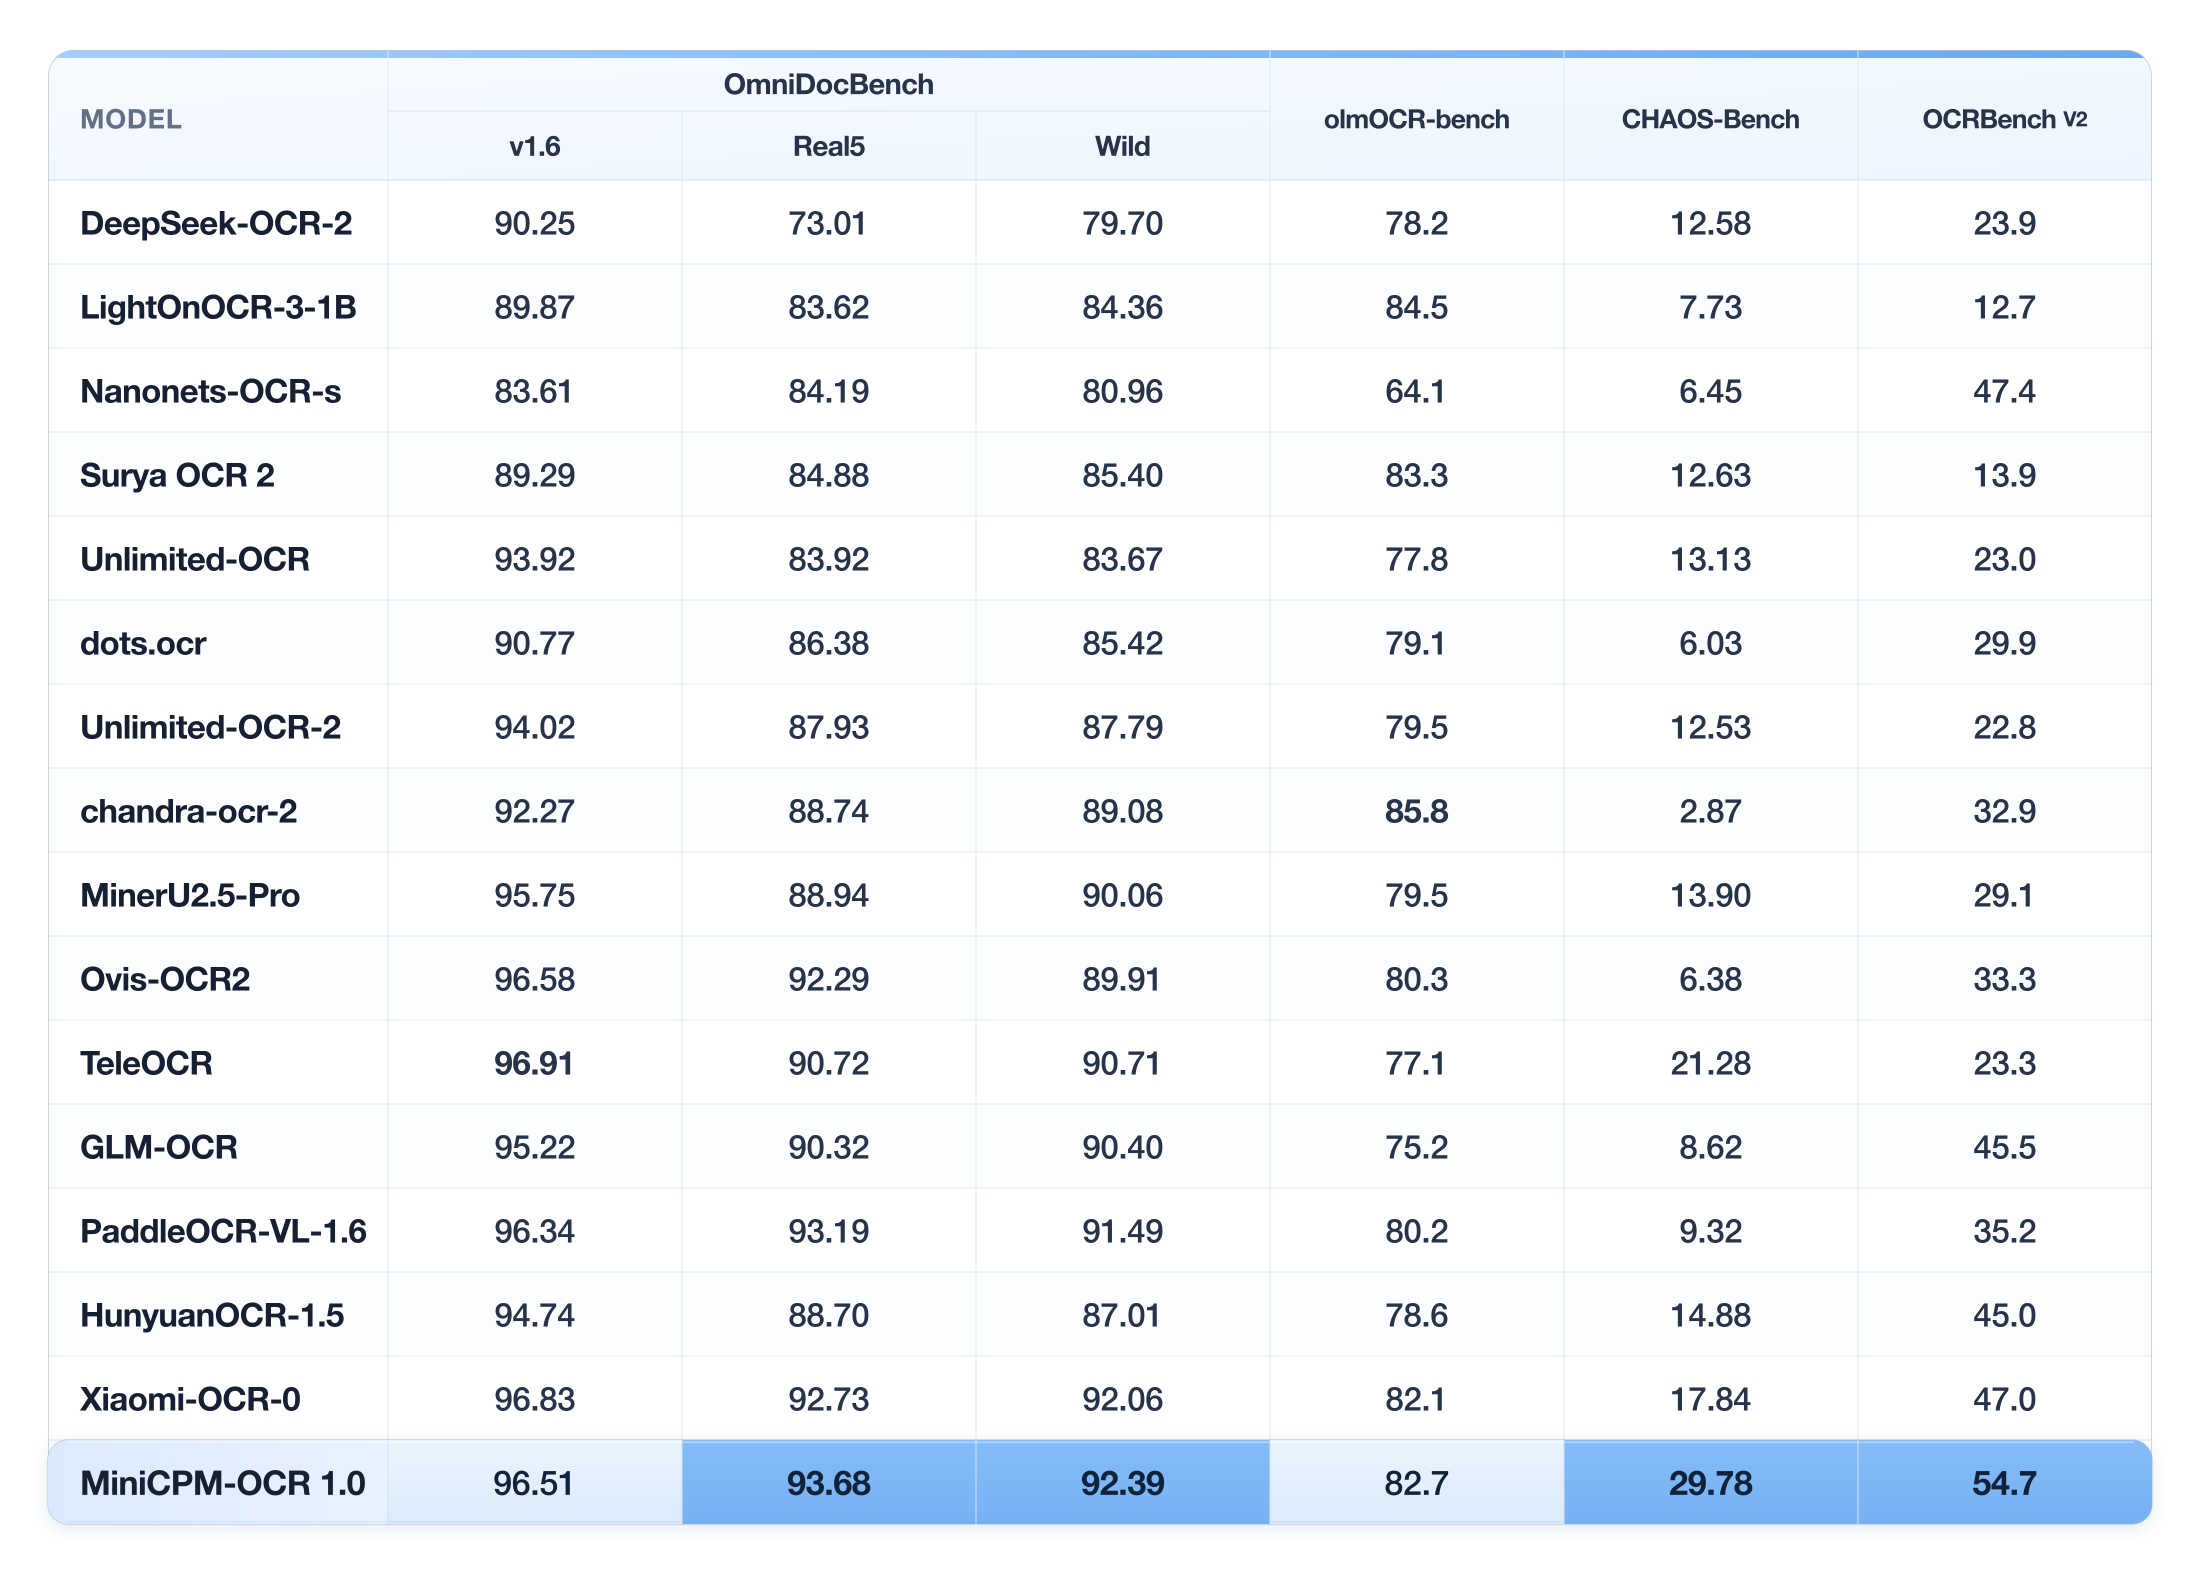
官方口径的成绩:Real5-OmniDocBench 93.68、Wild-OmniDocBench 92.39、OmniDocBench v1.6 96.51、olmOCR-Bench 82.7、OCRBench v2 54.7,称四项文档解析基准的等权平均分为开源第一。效率侧靠自研 DSpark 投机采样,端到端提速 55%,单张 RTX 5090 上 1.2 页/秒,吞吐约为 PaddleOCR-VL-1.6 的 1.49 倍、MinerU2.5 Pro 的 3.62 倍。以上数字全部是发布方自测,没有第三方复跑。
配套的 Jev 是 2B 判别模型,不输出文本:它吃「原图区域 + 候选结果」,把 Qwen3.5-2B 的 lm_head 换成二分类头,直接给 0–1 的正确概率。JevOCRBench 上 AUROC(×100)93.6,高于 JEV-35B-A3B 的 90.1、接近 Qwen3.5-397B-A17B 的 93.8;换到 GLM-OCR、PaddleOCR-VL-1.6、小米 OCR-0 的输出上仍稳定在 91.9–93.4。这意味着 OCR 第一次以开源形态变成可插拔的两段:谁解析都行,判别层单独当门禁,人工复核只留给它拿不准的那部分。
原文链接:面壁智能 / OpenBMB 官方页面