Perplexity 用真实失败会话训练 Computer 智能体:工具调用失败率从 2.24% 降到 1.77%
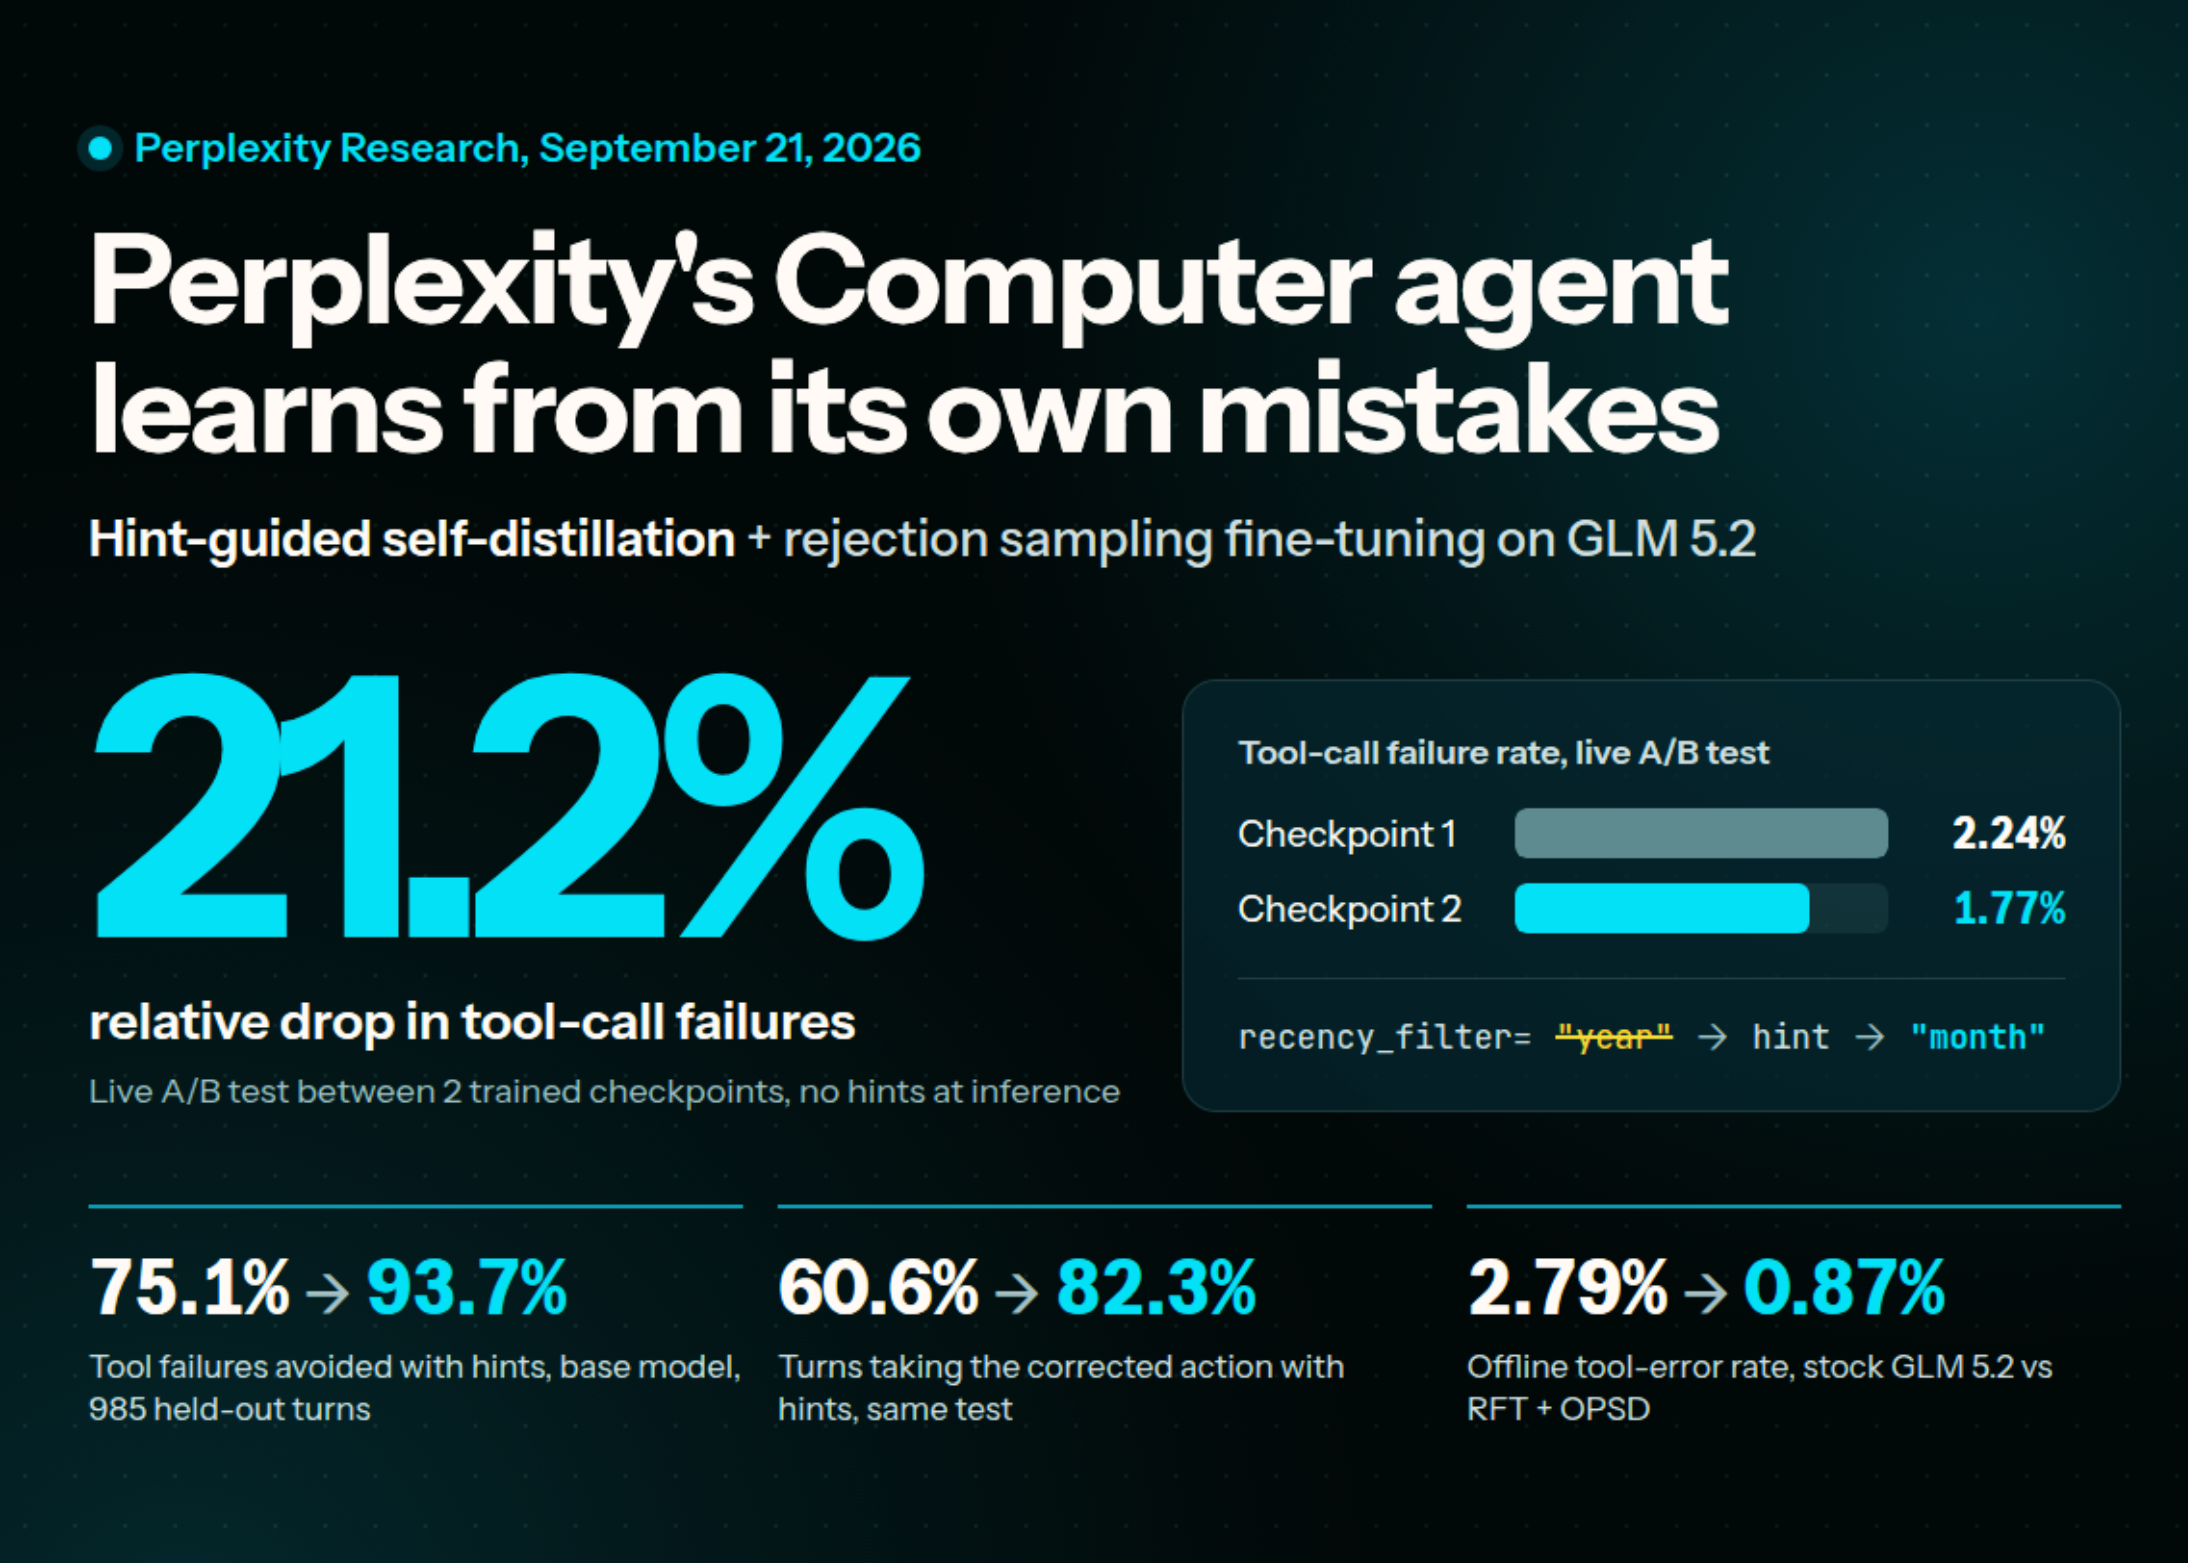
Perplexity 发布了一篇后训练研究,讲的是怎么让 Computer 智能体少犯错。做法是把真实用户会话(包括失败的)喂进模型,用拒绝采样微调配合提示引导自蒸馏,两条一起上。
效果是在线 A/B 测试里的:两个训练检查点之间,工具调用失败率从 2.24% 降到 1.77%,团队称这是 21.2% 的相对降幅,且有统计显著性。基座模型是 GLM 5 系列。
但要说清楚的是,Perplexity 没有放出后训练权重与训练代码,这个模型只作为 Perplexity Computer 里的一个模型选项存在。也就是说,方法可读、结果不可复现——目前能拿到的只是厂商自报的两个数字。
原文链接:Perplexity Research
核验记录
未直读官方原文:perplexity.ai/hub/blog 与 /hub/blog/* 直读 403、r.jina.ai 亦 403;Wayback 快照最新条目为 Aug 19《Brain: Agentic Memory as a Knowledge Wiki》,研究栏目列表页无本条。日期与全部数字取自 MarkTechPost 单篇页 JSON-LD datePublished=2026-09-25T14:30:26+00:00 与正文(正文写明 Perplexity Research published a new post-training study)。2.24%→1.77% 与 21.2% 相对降幅均为厂商自报,未经第三方复现。去重核查:库内「hint-guided」0 命中、「Perplexity Computer」0 命中、「1.77%」0 命中;「自蒸馏」1 命中为无关条目。
← 上一篇Exa 发 Agent Ultra:跨数千来源并联的智能体群,WANDR 上称比 GPT-6 Astra 高 213%下一篇 →Anthropic 与 Akamai 签 116 亿美元七年云算力协议:累计算力支出预计突破 5,000 亿美元