上海AI Lab 发 InternW0-Δ:20K 小时具身语料预训练的世界动作模型,RoboDojo 23.9% 略超 GPT-6 Astra
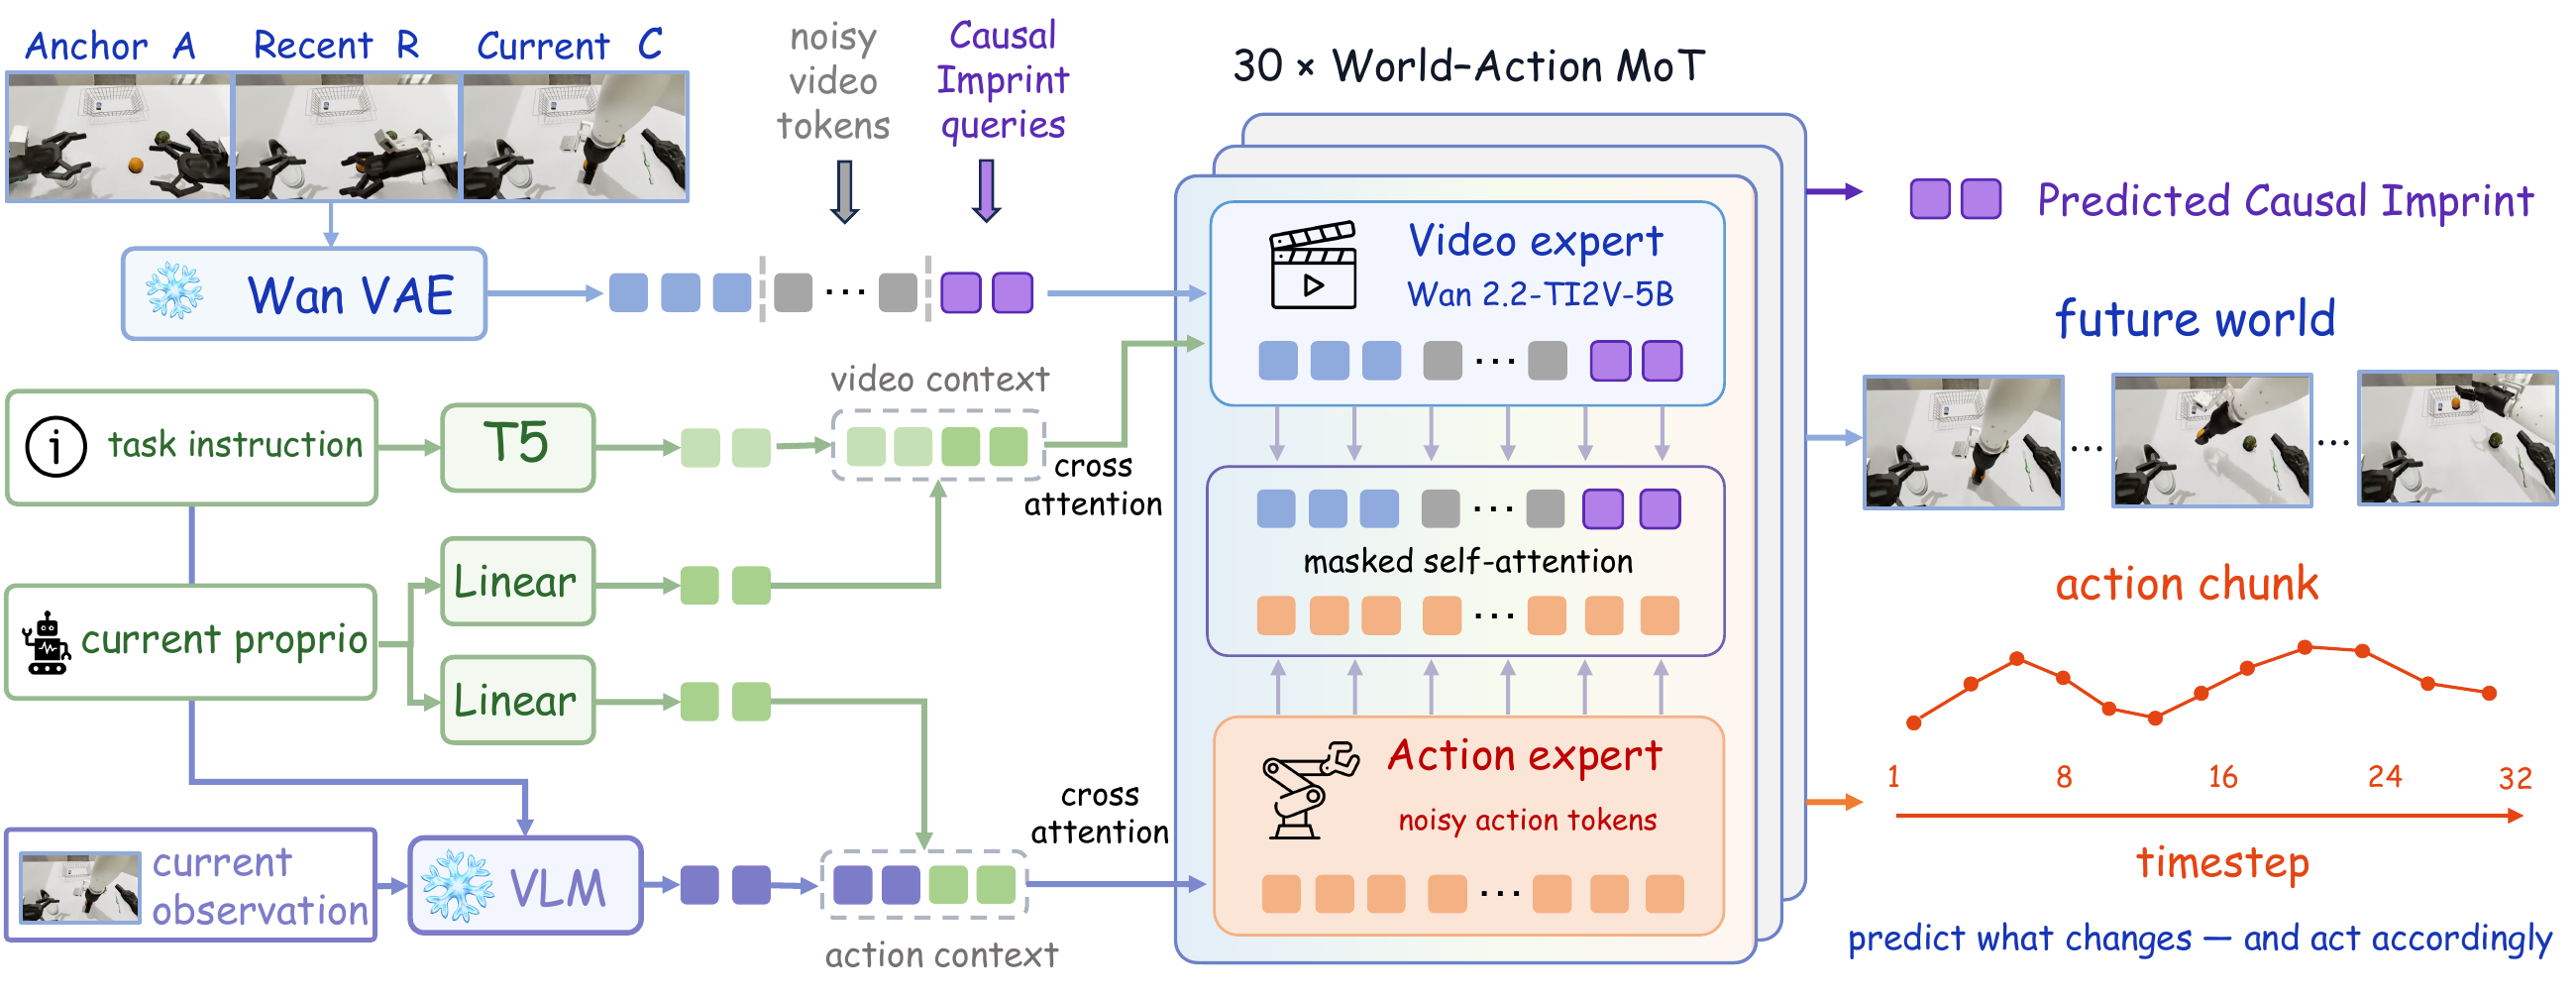
上海人工智能实验室(InternRobotics)把 InternW0-Δ 的技术报告放上 arXiv(9 月 25 日):一个把「预测视觉动力学」与「生成机器人动作」合进同一个模型的世界动作模型(WAM)。骨架是 Mixture-of-Transformers——预训练的视频专家与动作专家参数分开,只在受掩码约束的联合注意力里交换信息;文本与本体感知条件视频专家,冻结的 VLM 把指令与当前观测编码成场景语义喂给动作专家,另有一个冻结的 4D 基础模型在训练期蒸馏几何与运动先验。项目页与论文同日上线,页面上「训练代码 / 模型权重」两栏仍标 Forthcoming。
它对准的是 WAM 的老毛病:要预测未来,就得在推理时真把未来视频生成出来,又贵又容易跑偏。InternW0-Δ 引入 Causal Imprint——一组可学习查询只在训练期接受未来监督(隐变量差分监督 + 未来特征对齐),学到「与动作相关的场景变化」表征,推理时直接把这组表征交给动作专家,不做未来视频 rollout;再配 Sparse Memory Context,只保留锚点、最近与当前帧,不用稠密的视频历史。论文说这两处加上视频/动作双专家的定向注意力,是它比同量级基线稳的原因。
数字都是项目页对比表里的官方自测:LIBERO-Plus 92.8%、RoboTwin Clean2Random 71.9%、RoboTwin Clean2Clean 90.0%、RoboDojo 23.9%、EBench 49.2%——四项高于表内基线,EBench 略低于 OpenWAM-α 的 49.4%。RoboDojo 这一项超过同一张表里的 GPT-6-Astra(22.48%),但不同团队公布的 RoboDojo 口径未必一致(另一份公开材料里 Simate-beta 报 27.96%),跨家比较要留余地。更长期的筹码在语料:机器人演示、UMI 数据、第一人称人类演示等异构数据对齐到统一的状态-动作表示后超过 2 万小时,官方称是同类中最大的开源语料。
原文链接:上海人工智能实验室项目页 / arXiv