英国 AISI 开源 Transect:把一次智能体评测的整份 transcript 变成一份可以逐句核对的交互报告
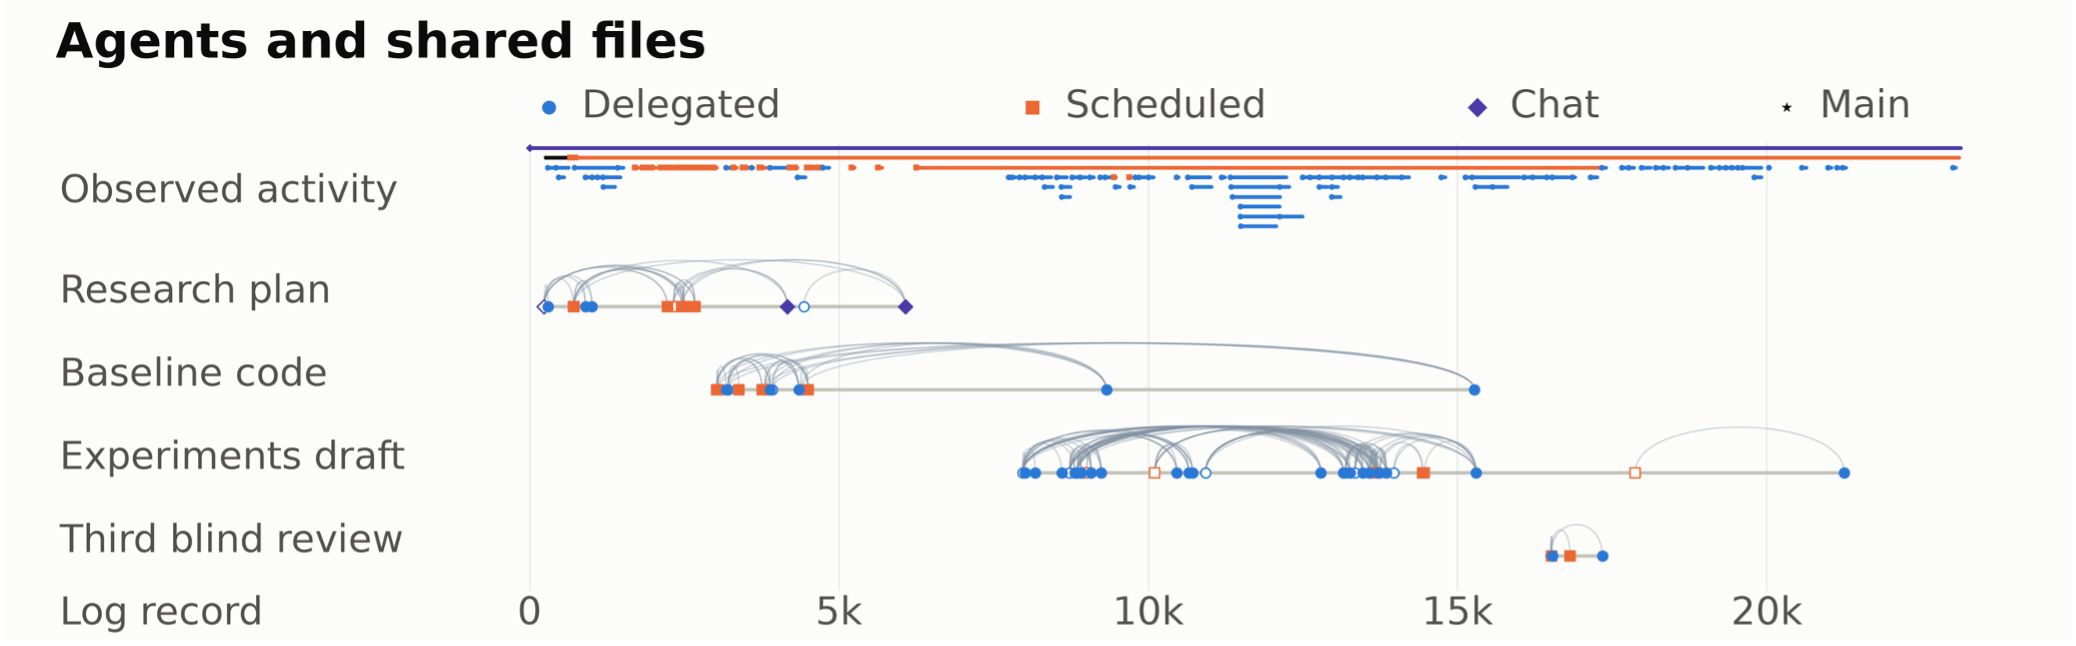
英国 AI 安全研究院(AISI)10 月 7 日发布 Transect,一个开源的 Python 包,构建在 Inspect Scout 之上,由 Meridian Labs 支持。它要解决的是评测侧的一个具体失真:智能体在长评测里写代码、跑实验、互相委派任务,最终只有一个分数,而这些过程——它试过哪些策略、卡在哪、测试装帧如何塑造了它的行为——都留在 transcript 里,靠人读一遍要花大量时间与领域知识。
让大模型来读(LLM-as-judge,或 Inspect Scout 里的 judge scanner)可以自动化这件事,但官方直接点出风险:这类判断可能出错或产生误导。所以 Transect 的设计是「把自动分析与它的证据放在一起」——把一次评测 run 的复杂度压成一份交互报告,评审可以顺着流程走,同时看 token 使用、子智能体活动等信号,并跳到对应的 transcript 段落去核对那一步判断站不站得住。
这条的意义落在「高能力智能体的评测是否可复核」上:当评测行为本身已经复杂到单一分数无法承载,评测的产物就必须从分数变成可追溯的证据链,否则评测结论与它声称的严谨性之间就出现缺口。值得注意的是,这次把「自动判断会出错」这句话写在官方发布文里的是评测机构自己——它的处置不是不用大模型当裁判,而是把「判断」与「判断的依据」一起交给评审去看。
原文链接:AISI 官方博客
核验记录
官方页直读 200 / 32,263 字节,页内可见发布日期 Oct 7, 2026(该页无 JSON-LD datePublished、无 og:article:published_time,日期只有这一处可见文本)。「开源 Python 包」「构建在 Inspect Scout 之上」「由 Meridian Labs 支持」「judge 判断可能出错或误导」「可同看 token 使用与子智能体活动」均逐句取自该页正文。配图:该页无 og:image,取自正文本体插图 cdn.prod.website-files.com/.../figure2.png,裸请求与带站内 Referer 双向 200 / 260,459 字节 PNG(2076×646,file -b 已验真)。若该页日后换图,此链可能失效。
← 上一篇TII 发 Falcon-ASR:1.6B 语音识别专攻阿拉伯语与阿联酋方言,六测试集平均 WER 20.92% 超过公开最好成绩下一篇 →AWS 开源 Strands Box:用语义策略把智能体关进本地沙箱,「它已经做过什么」也参与放行判定