Artificial Analysis 发布智能指数 v5:六成题库改为私有
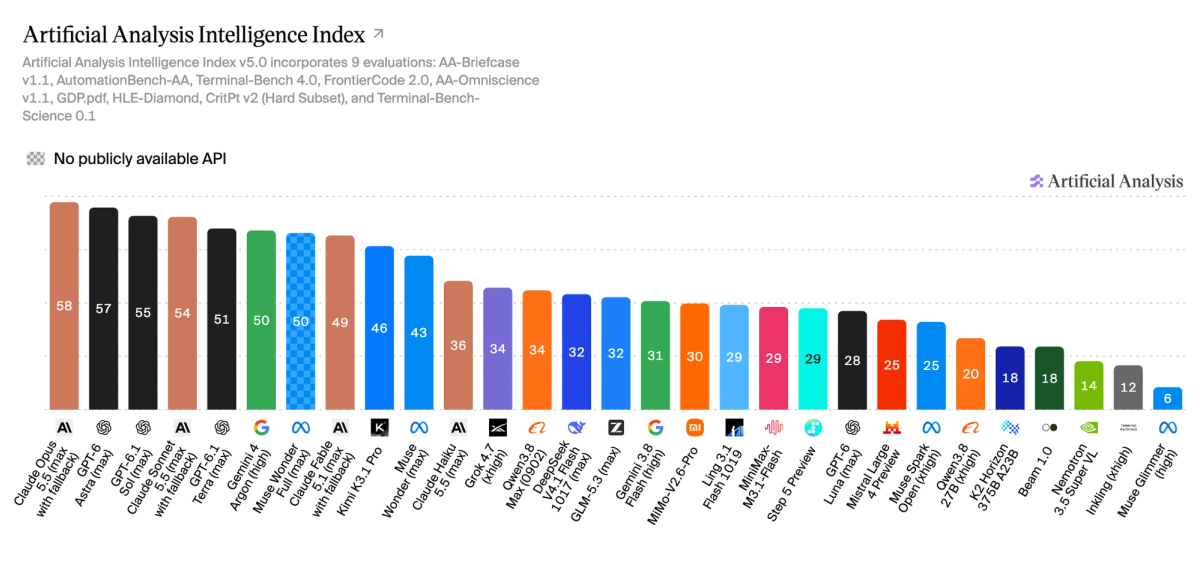
Artificial Analysis 把旗下智能指数升级到 v5,称是 v4 以来最大一次改版:新增两个基准(Cognition 的私有编码基准 FrontierCode 2.0、70 道题的 Terminal-Bench-Science),升级 HLE-Diamond、AA-Omniscience v1.1 与 CritPt v2 私有子集,移除 GDPval-AA v2.1、SciCode 与 AA-LCR v1.1,知识工作、编码、科学、通用四项各占 25%。关键变化是 60% 的评测改用私有测试集或留出答案,官方称这是首次让指数的多数部分建立在私有数据上。
结果:Claude Opus 5.5(max)58 分居首,GPT-6 Astra 57、GPT-6.1 Sol 55,Gemini 4 Argon 50;开源权重与闭源的差距从 3 分扩大到 12 分——Kimi K3.1 Pro 以 46 分居开放权重首位(权重尚未放出),已放出权重的 DeepSeek V4.1 Flash 1017 与 GLM-5.3 只有 32 分。成本端差距更直观:Top10 里 GPT-6.1 Terra 每任务 0.96 美元最便宜,Claude Fable 5.1 每任务 13.04 美元最贵,差 13 倍以上。
这条的意义在度量本身:智能指数是本站常引用的口径之一,v5 之后同一模型的分会变,跨版本的分数对比不再成立;同时「开源追平闭源」这句话在新指数下的证据变弱了——差距不是消失了,而是 12 分。引用分会被新模型不断改写,真正长期可比的是 v5 的权重结构与题库。
核验记录
官方文章页经 r.jina.ai 渲染给出 Published Time 2026-10-27,同站文章列表同篇标 October 27, 2026,两处同日。同站 10-28 的「Gemini 4 Carbon 登顶」是另一篇文章,本条不与它混用日期。分数、权重结构、成本数字均直读该文章页;未直读各基准的原始榜单页。配图 cdn.sanity.io,裸请求与带站内 Referer 双 200 / PNG 1200×567。