Kyutai 开源 REKI:2.4B 机器人 VLA 只喂公开数据,LIBERO-Plus 90.4 反超两倍大的模型
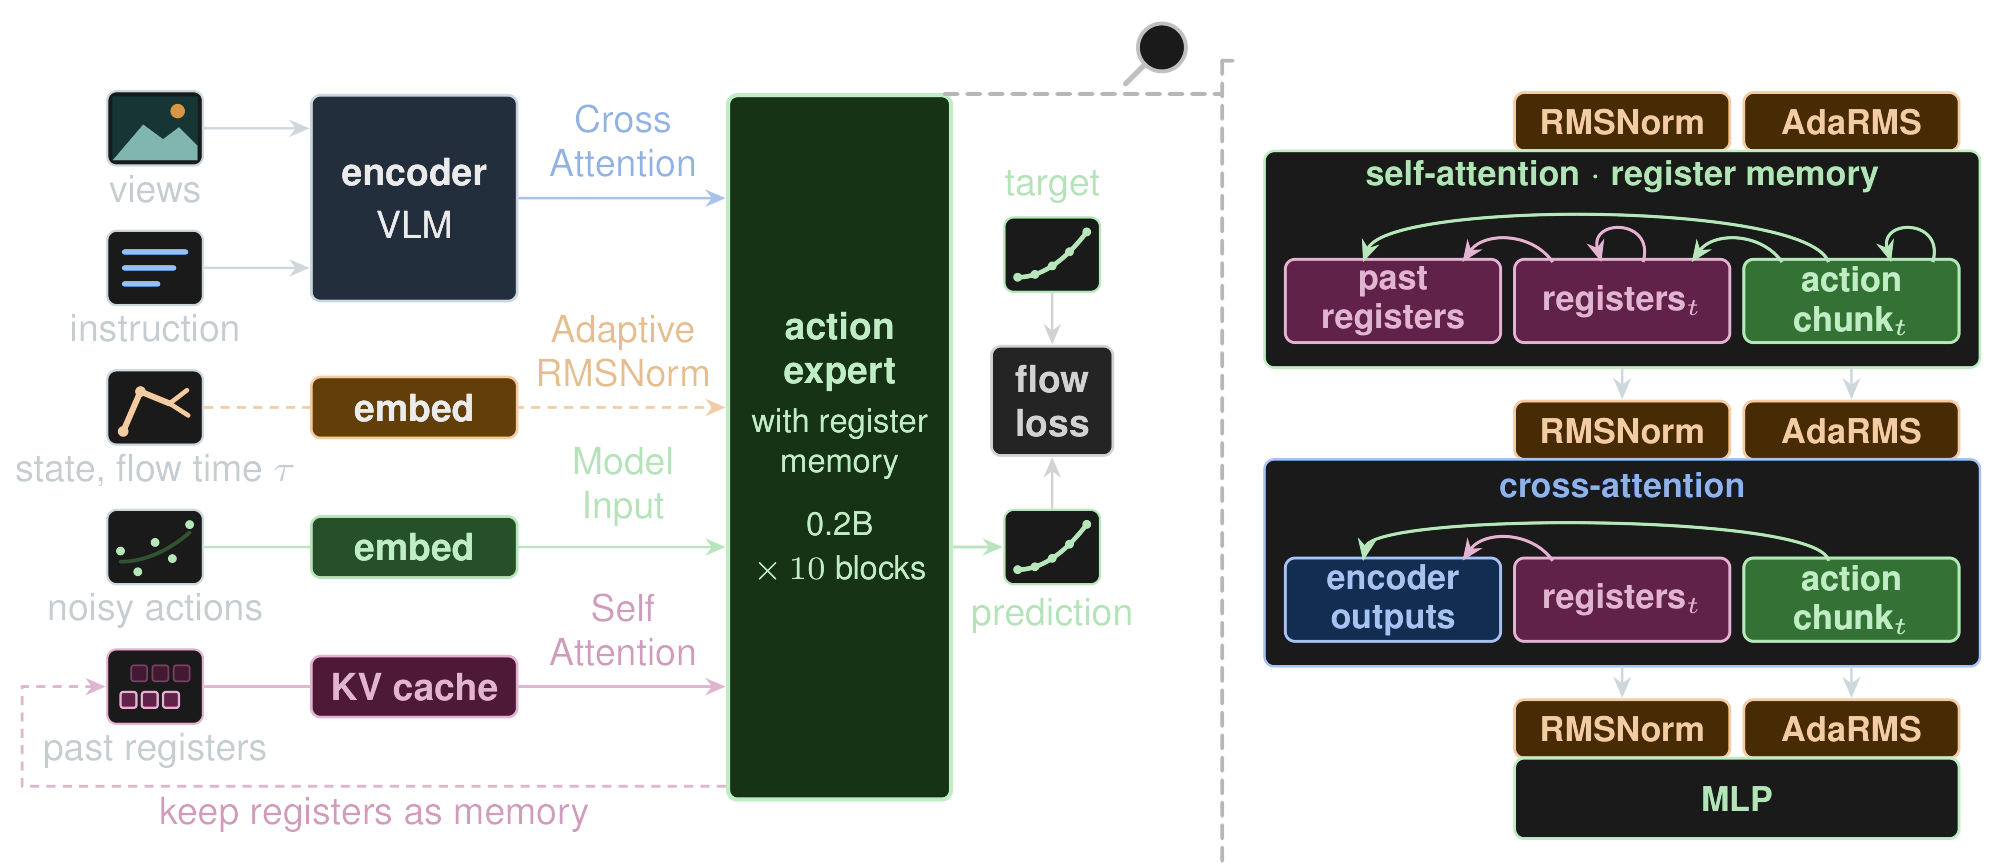
Kyutai 与 Inria、École nationale des ponts et chaussées 一起放出 REKI:一个 2.4B 参数的视觉–语言–动作模型(VLA),由 2.2B 的视觉语言骨干与 2 亿参数的流匹配动作专家组成。骨干用 Qwen3.5-2B 编码相机画面与指令,动作专家的每个 block 通过交叉注意力读取这份上下文,机器人状态与流匹配时间步则通过自适应归一化调制动作输出。
它的新意集中在动作专家的记忆上:每一帧的动作 token 前固定放 32 个可学习的寄存器 token,它们只交叉注意该帧的指令与画面、并在帧之间互相自注意,于是每帧只需编码一次,也不必引入额外模块、训练时的序列展开或测试时的状态更新。官方称读这份缓存的代价不到预测一个动作块耗时的 1%,而记忆让 LIBERO-Plus 成功率提高 1.5 个点、RoboTwin 干净场景提高 5.5 个点、RoboCasa365 提高 5.4 个点,并让机器人在两个姿态之间来回振荡的情况大约少了四分之三;编译后,单张 H100 从两张 256×256 画面推出一个动作块耗时 21.8 毫秒。
预训练只用公开数据:约 10 亿帧真机遥操作、仿真与第一视角人手视频,外加 1,220 万条视觉语言样本,在 32 张 H100 上跑 20 万步。结果是 LIBERO 四套件均值 97.6、LIBERO-Plus 90.4、RoboTwin 2.0 简单/困难 85.9/84.6、Clean2Rand 65.8、RoboCasa365 38.4;在「只用公开数据预训练」这一类里,它比 InternVLA-A1.5 在 LIBERO-Plus 上高 5.6 分、比 ABot-M0 在 Clean2Rand 上高 10.1 分,真机 UR5 上则比 π0.5 高 7 到 37.5 个百分点。官方同时开放数据清洗、训练、推理、评测与真机部署的全套代码,以及预训练与五个基准微调的六份权重(权重 CC BY-NC-SA 4.0、代码 MIT),微调成本是真机任务 8 张 H100 小时、基准任务 40 到 400 小时。
原文链接:Kyutai 官方项目页 / 模型卡