腾讯放 DSpine 草稿模型:并行起草、因果按深度串,Qwen3-8B 接受长度 7.83 压过 DFlash2
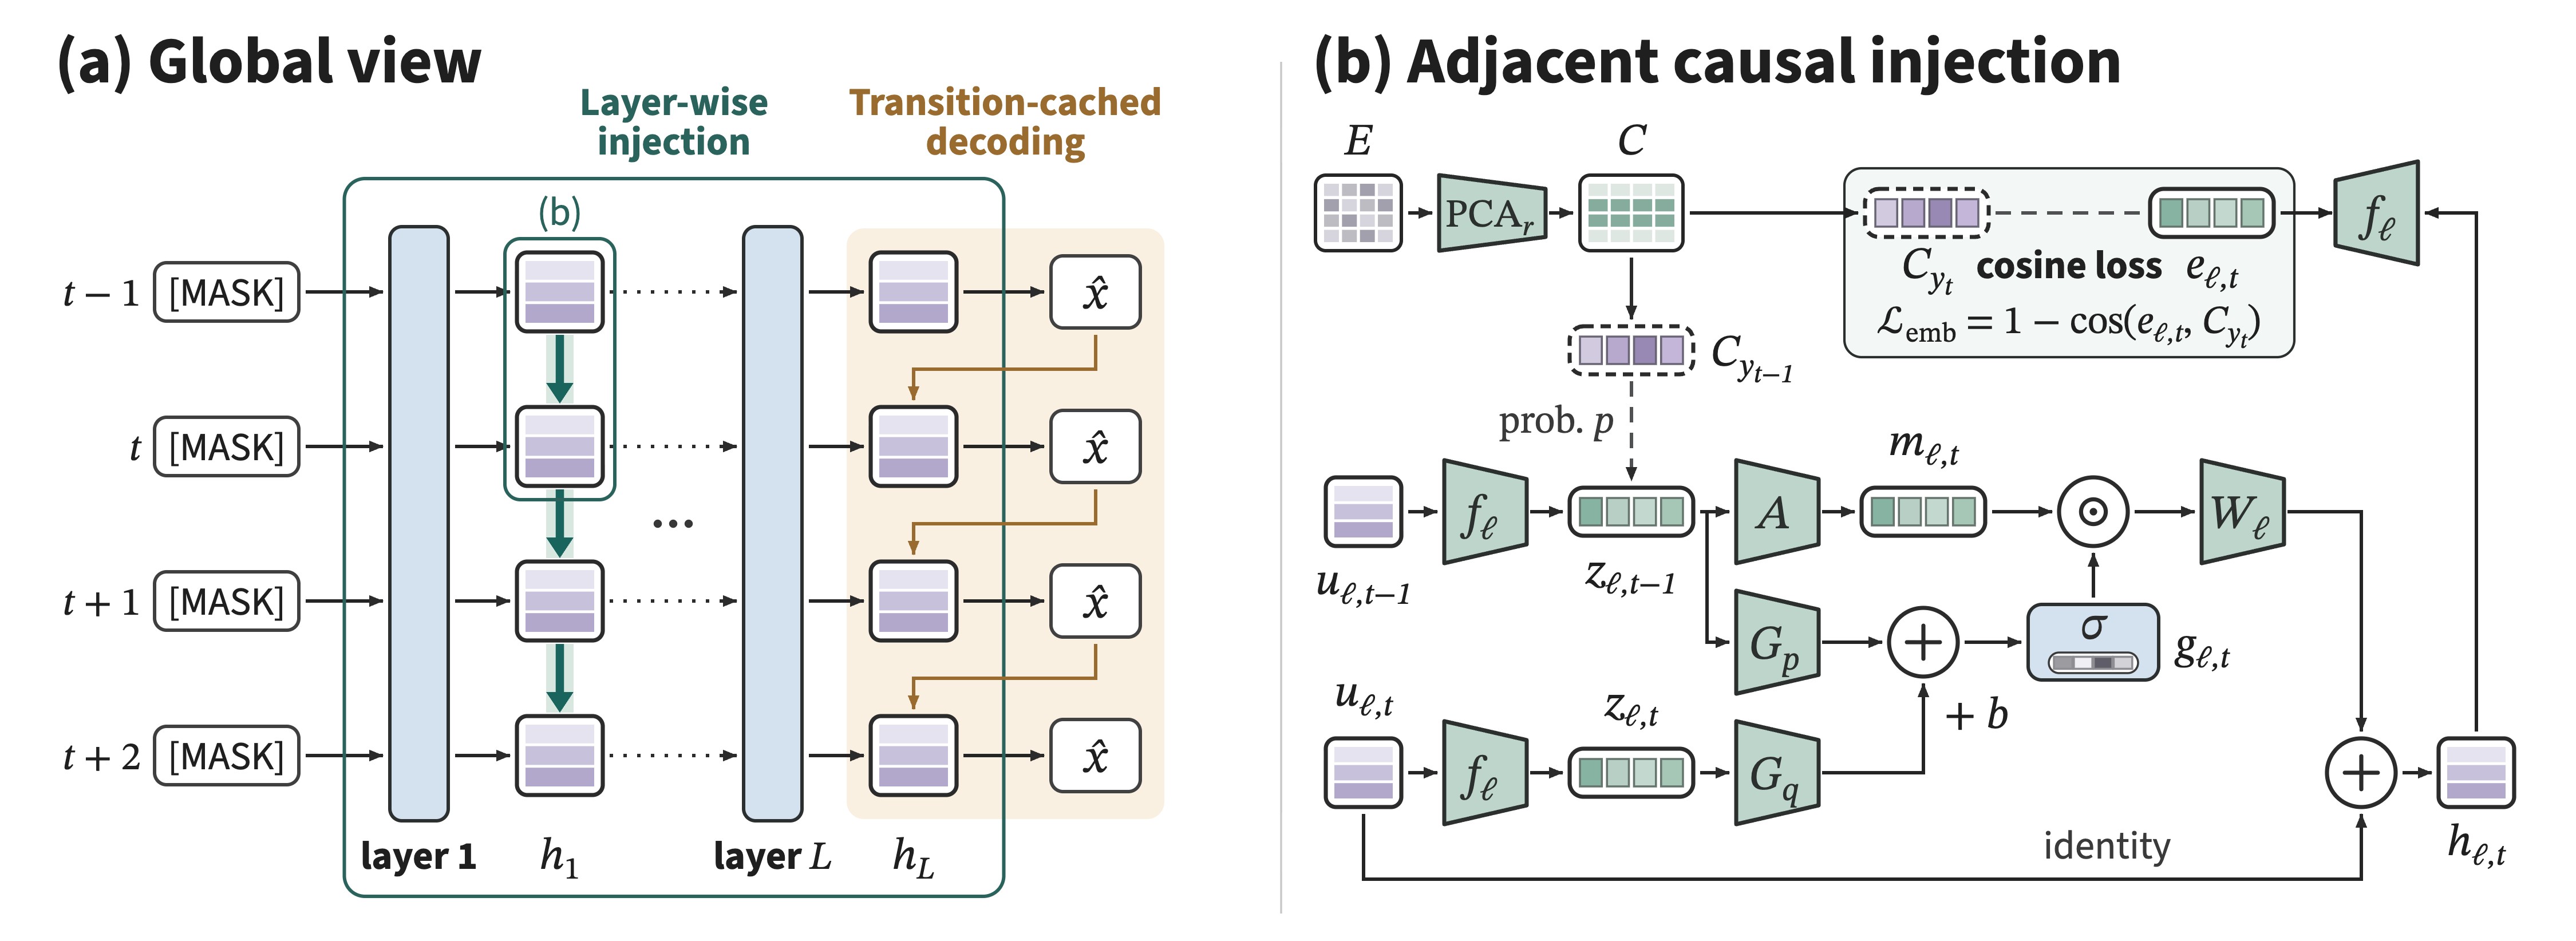
腾讯放出的 DSpine 是一个「并行起草、但因果按网络深度串联」的推测解码草稿模型。并行起草能在一次骨干前向里生成多个候选 token,代价是各位置独立挑选会产出彼此不一致的续写、把可接受的长度压短;已有做法多把条件化解码交给骨干之后的轻量模块,于是前驱信息往下游流动受限。DSpine 的做法是在骨干每一层做门控的相邻注入:把前一个位置的预测特征写进后一个位置,因果条件链沿深度展开、所有位置仍并行更新;再以目标模型输出嵌入构成的统一传递空间,把逐层注入与前驱条件化解码接到一起,并用融合算子与转移缓存在 SGLang 里并行执行。
实测在 Qwen3-8B 上(temperature 0,与 DFlash2、DSpark、Domino、DFlash 在同一份 Open-PerfectBlend 上同配置重训)七个基准的接受长度均值 7.83,高于 DFlash2 的 7.55、DSpark 的 7.44 与 DFlash 的 5.92;分项 GSM8K 10.55、MATH-500 10.30、HumanEval 8.27、MBPP 7.66、LiveCodeBench 7.25、MT-Bench 5.63、Arena-Hard 5.13,七项均为最长。temperature 1 下均值 6.98(DFlash2 6.53)。SGLang 服务测试中,它相对 DFlash 的平均吞吐高 23.3%。
权重与推理代码已经开放:Hugging Face 上的 tencent/Qwen3-8B-DSpine-b16 采用 Apache 2.0,推理按 SGLang 的 DSPINE 算法跑、草稿 token 数 16。项目页列出的后续计划是补训练代码与 Qwen3.8-27B 版本,两项都尚未发布。论文 arXiv 2609.36173 于 2026 年 9 月 28 日公开。