Meta 摊开 Prometheus:首期已训完 Muse,满规模约 100 万块 GPU
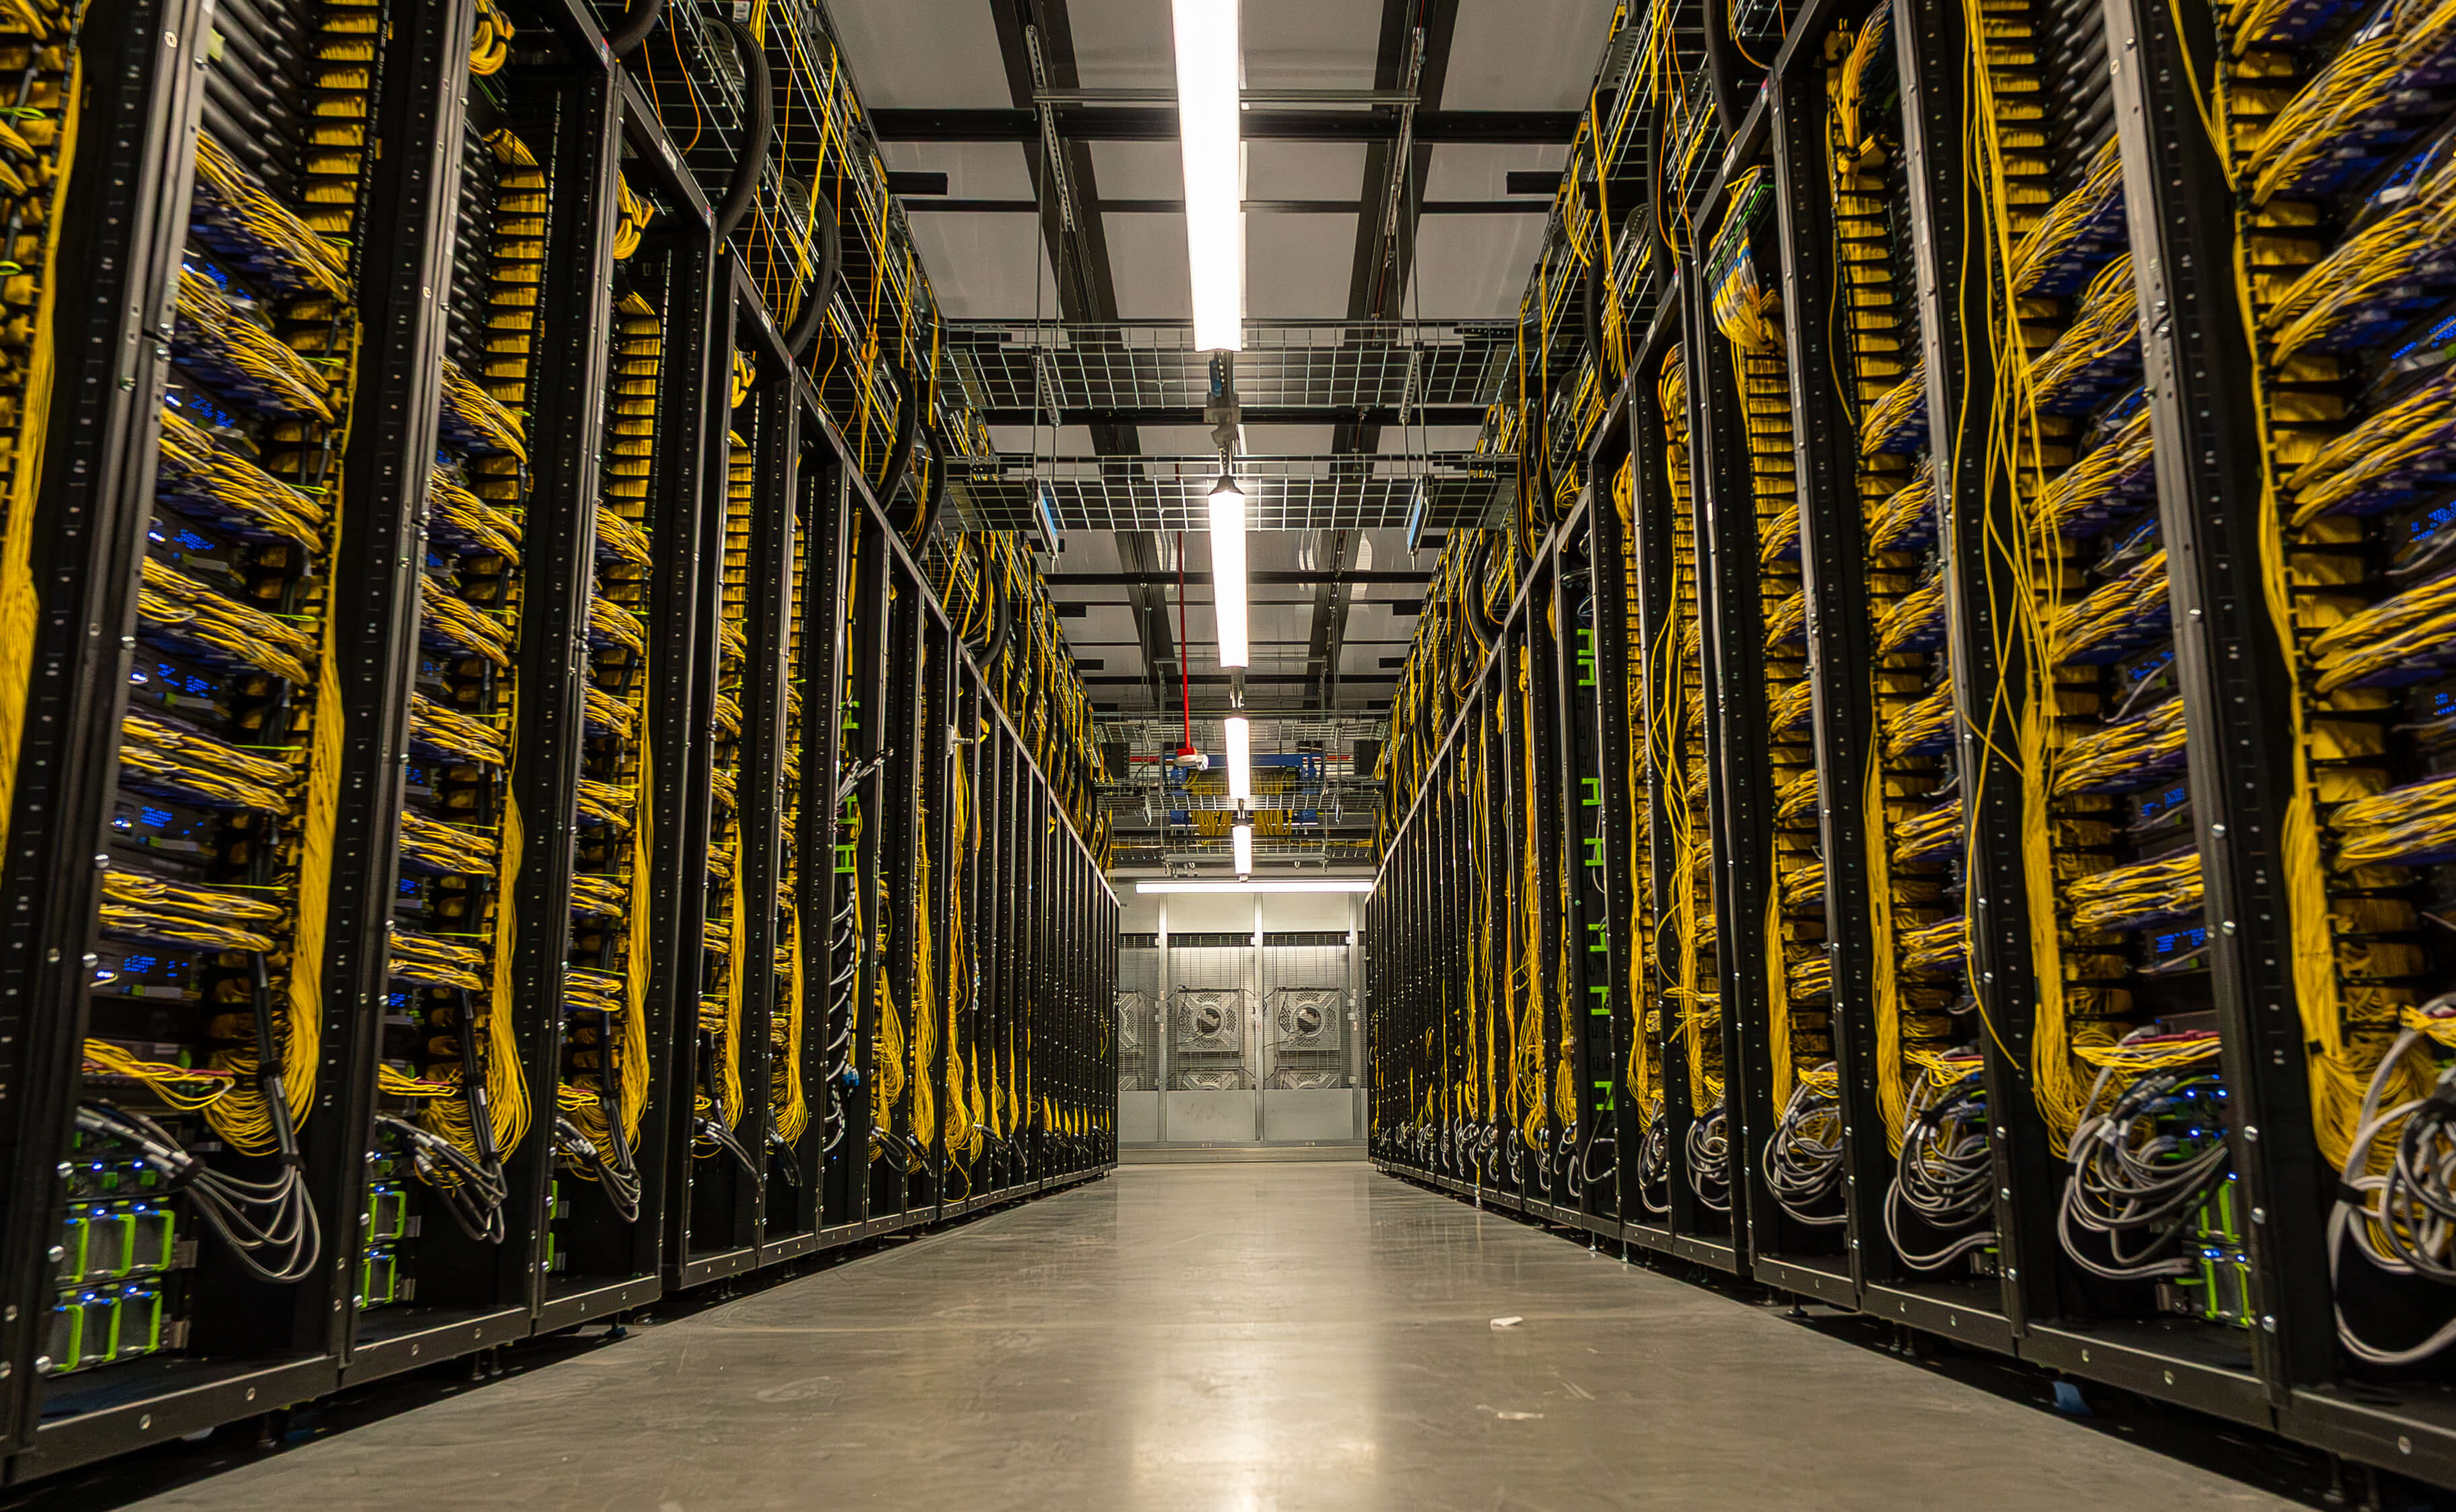
Meta 10 月 19 日在工程博客首次系统公开 Prometheus:位于俄亥俄州 New Albany 的吉瓦级超算集群。首期已经建成,并用于训练 Muse 系列基座模型(含 10 月 12 日发布的 Muse Wonder);目前由分布在多栋互联建筑中的数十万块 GPU 组成,官方目标是满规模约 100 万块,以「一台机器」的方式协同运行。
硬件上已上线两代 NVIDIA 平台:Catalina 用 GB200 NVL72 的两机架 Ariel 变体,每机架 36 块 GPU 经 NVLink 拼成 72 GPU 域,CPU 与 GPU 1:1 配比;Clemente 换到 GB300 NVL72,HBM 从 192GB 提到 288GB、FP4 稠密吞吐同比提升;基于 Vera Rubin NVL72 的第三代「很快到位」。楼内以太网 fabric 单层最多互联 20,736 块 GPU,跨楼的 BAG 骨干跨 2 到 100 公里。官方给出的效率数字是 Muse Wonder 预训练 goodput 超过 85%、强化学习任务超过 90%。
这条消息的分量在刻度而不是新模型:一个训练集群从十万卡级推到百万卡、吉瓦级,意味着网络、供电与散热开始和 GPU 一起决定前沿模型的训练节奏——Meta 自己也把网络说成「AI 工作负载的一部分」,而不是配套设施。需要标注的是,85% 与 90% 的 goodput 以及「单机」表述都是 Meta 自述的工程口径,没有第三方复测,文中也没有给出总功率与全部建成的日期。
原文链接:Meta 工程博客
核验记录
官方页 engineering.fb.com/2026/10/19/data-center-engineering/inside-prometheus-meta-gigawatt-scale-supercluster/ 直读 200(130,921 字节):JSON-LD datePublished 与 article:published_time 均为 2026-10-19T13:00:10+00:00,页内可见 POSTED ON OCTOBER 19, 2026,两处同日。配图 og:image(Prometheus-NAO_-5-1.jpg)裸请求 200 / 1,165,561 字节,带站内 Referer 同样 200,file 校验为 JPEG 3648x2246。库内此前只在 10-12 的 Muse Wonder 条目正文里提过一句「自有吉瓦级 Prometheus 数据中心」,没有独立条目,本条是首次公开的独立事件,不算重复(R34)。goodput 与规模数字全部按 Meta 自述写,未第三方复测。