vLLM 重写 Kimi K3 解码路径:16 张 GB300 上 batch1 到 842 tok/s,GPU 内核由智能体辅助写
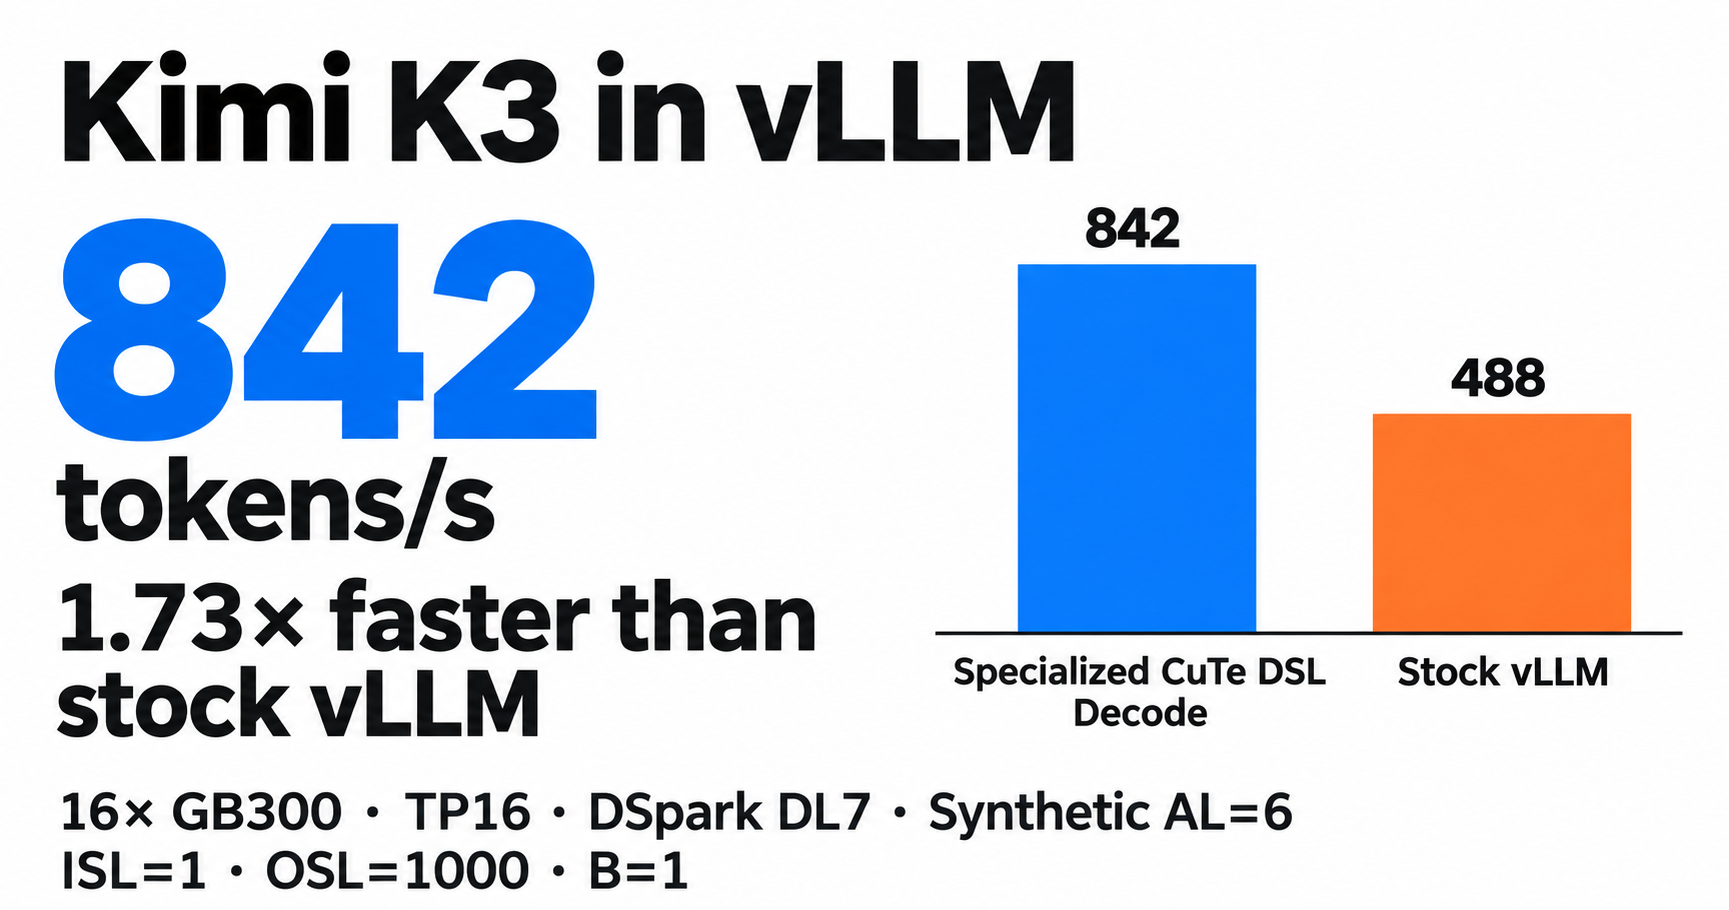
vLLM 在 10 月 16 日发布博文(作者为英伟达工程师 Benjamin Chislett),把 Kimi K3 的解码路径换成一条统一的 CuTe DSL 路径,覆盖注意力、MoE 与多卡通信,适配 8 或 16 张 GB300。效果:batch 1 解码在 DSpark 投机解码下达到 842 token/s,同一设置下原版 vLLM 是 488,即 1.73×;关掉投机解码后,16 卡在 batch 1 到 64 的各档仍有 1.62–1.92× 提升(batch 1 为 256.4 token/s、batch 64 为 3,606.1),8 卡为 1.31–1.58×。逐层看更直观:原来每层 23 个内核、130 微秒,合并后 13 个内核、69 微秒。
这篇博文的关键词是 agent-assisted——写复杂 GPU 内核、做跨算子融合、把计算与通信重叠、按 batch size 与卡数调形状与权重预取,都由编码智能体参与完成。真实编码会话流量的 AgentX 回放上,并发 1 的 P90 交互性从 223.7 提到 403.2 token/s/用户;不过官方自己注明了:这次是 16 卡对早先 8 卡的结果,不是同硬件对比。
它同时说出一件流程上的事:优化代码已经跑到人工评审前面了。vLLM 因此提出「快速通道模型优化 RFC」,用四条原则替代逐行读代码——把改动隔离在模型自己的代码里、限定范围但不砍用户功能、系统化验证正确性、广泛测性能;人工评审从读每一行退到看设计与证据。文末也交代了为什么 842 是受控数字(合成接受长度 AL=6、不含 prefill),并呼吁公共算力支持以扩展 CI 覆盖。
原文链接:vLLM 官方博客
核验记录
一手页 vllm.ai/blog/2026-10-16-kimi-k3-megakernel 直读 200 / 127,957 字节(正文 16,632 字符),JSON-LD datePublished 与 og:article:published_time 均为 2026-10-16,作者署名 Benjamin Chislett (NVIDIA),页内可见 October 16, 2026。数字逐字直读核过:842 vs 488 tok/s(TP16、DSpark 七个草稿 token、合成接受长度 AL=6、ISL=1、OSL=1k、batch 1)= 1.73×;无投机解码表 TP8 1.31–1.58×、TP16 1.62–1.92×(batch1 256.4、batch64 3,606.1);每层内核 23 个/130 微秒 → 13 个/69 微秒;AgentX 并发 1 的 P90 交互性 403.2 vs 223.7 token/s/用户(官方注明是 16 卡对早先 8 卡,不是同硬件对比);842 为受控条件、不含 prefill。原文自述该路径是 agent-assisted 开发,并给出「快速通道模型优化 RFC」的四条原则(隔离改动、限范围、验证正确性、广泛测性能)。配图 1729×910 PNG,裸请求与带站内 Referer 双 200(含原串查询参数 ?v=1d7f9709fbdf,按 R43 原样取用)。本项目非第三方复现测试,数字均为 vLLM / NVIDIA 一方口径。
← 上一篇小米发 Xiaomi-Lens-0:4B 多模态用 mask token 直接从共享骨干解出分割掩码下一篇 →腾讯放 DSpine 草稿模型:并行起草、因果按深度串,Qwen3-8B 接受长度 7.83 压过 DFlash2