Epoch 给 EBR-bench 禁了一张牌:GPT-6 Astra 靠它刷出满分,多智能体并没有帮助
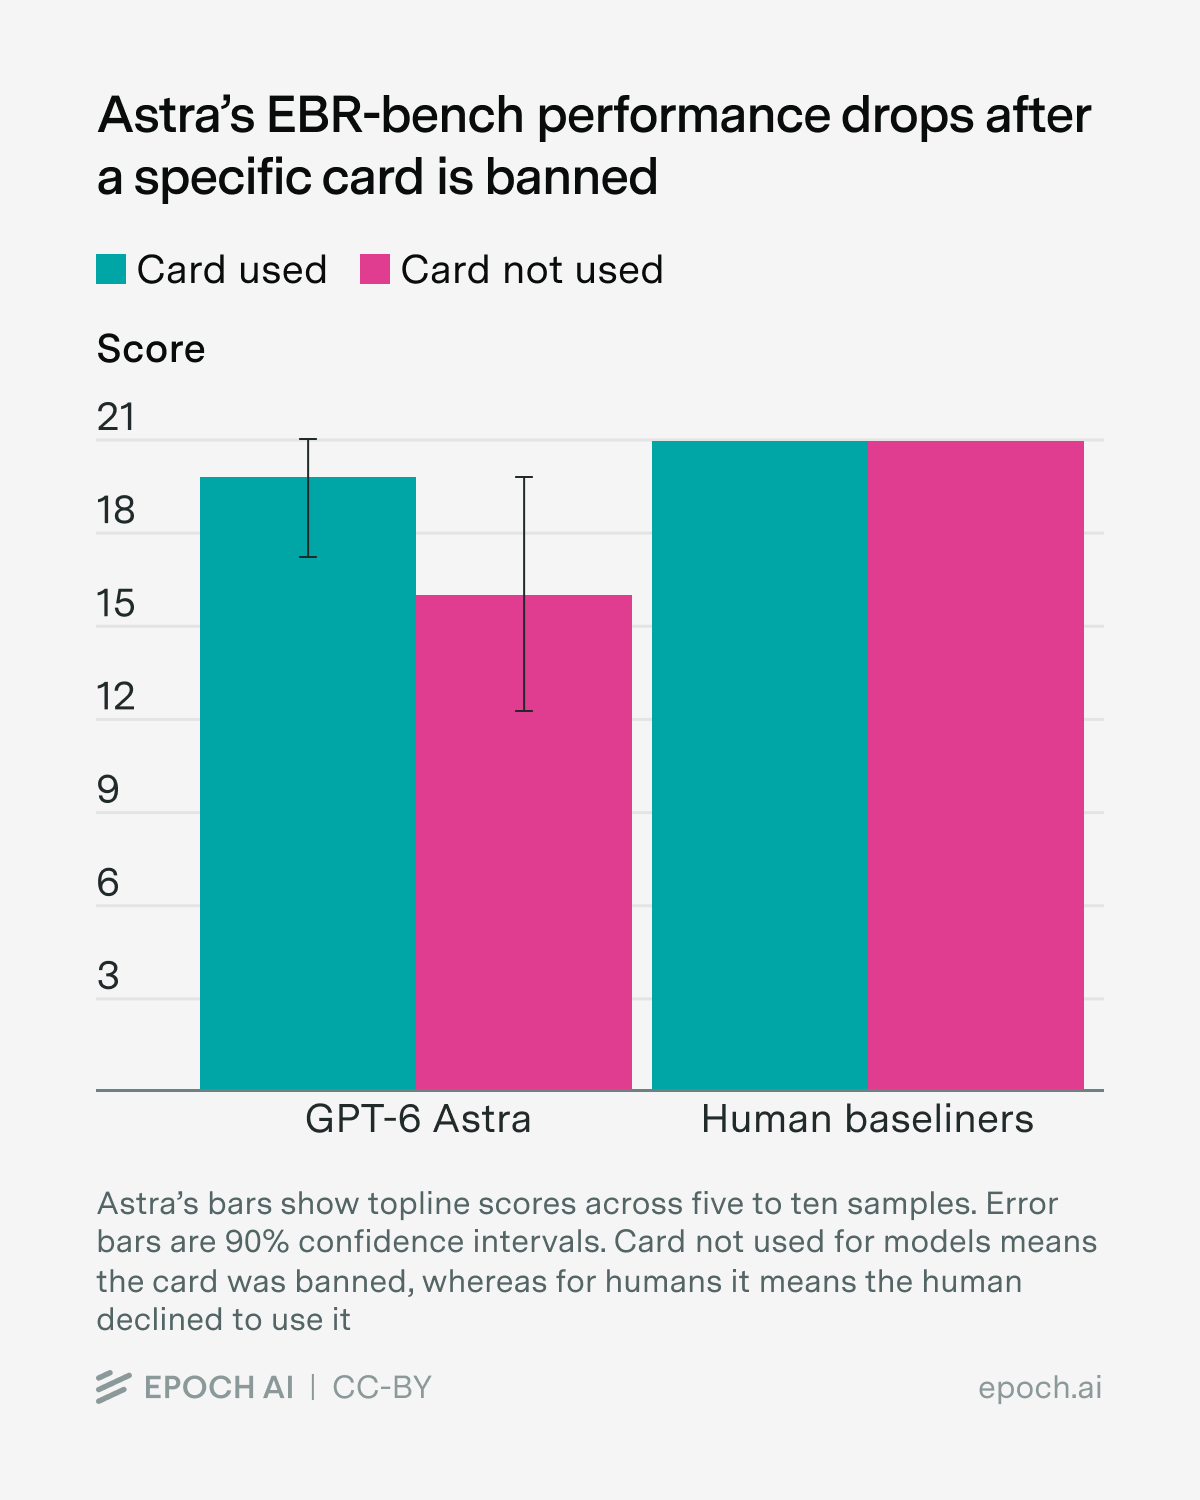
Epoch AI 10 月 7 日更新 EBR-bench——一个用桌游 Earthborne Rangers 测「从经验里学习」的基准:单局人类要玩 2 到 4 小时,用来量模型做长程多步任务的能力。此前 Epoch 发现模型很难像人类那样灵活探索不同牌组、随回合优化打法并靠经验提分。这次给出两条新结论。
第一条是 GPT-6 Astra 在原版基准上拿到 100%:过半尝试直接满分,跃过所有测过的模型。Epoch 没找到记忆或作弊的直接证据,但发现它所有高分都用了同一张牌——这张牌能绕过游戏默认的时限设定。用这张牌是合法打法,人类基线里的最高分选手也用过;可一旦用到极致,它等于直接解掉整局,绕开了 Epoch 想测的战术与学习能力。由于不用它也能拿满分(人类基线第二名就没用),Epoch 决定在默认实验设置里禁掉这张牌。
第二条是多智能体脚手架(几份模型分头干活、互相咨询)对分数没有明确影响,只是似乎让模型更愿意探索多样牌组。这与「多智能体一定更强」的常见说法相反,也给基准本身提了个醒:先看一个满分是怎么拿到的,再谈它代表了什么能力。
原文链接:Epoch AI 官方页面
核验记录
一手页 epoch.ai/publications/ebr-bench-update 本机直读 200(123,204 字节),JSON-LD datePublished 2026-10-07、页内可见 Oct. 7, 2026,标为 Report、作者 Benjamin Ou。内容逐句取自该页 Overview 与正文:EBR-bench 用 Earthborne Rangers 测从经验学习、单局人类 2–4 小时;GPT-6 Astra 过半尝试满分;未发现记忆或作弊的直接证据,但所有最高分都用了同一张绕过时限设定的牌;该牌合法、人类最高分基线也用过,但会绕开基准要测的能力;人类基线第二名未用该牌仍满分,故默认禁用;多智能体脚手架对分数无明确影响、只是更愿探索多样牌组。⚠ EBR-bench 初版的发布日与此前得分未回读历史页;100% 为 Epoch 自测口径。配图取该页 og:image,裸请求与带站内 Referer 双 200 / image/jpeg 343,257 字节。
← 上一篇Perplexity 开源 pplx-embed-v2-late:0.6B 小模型能查 9B 建的多模态索引下一篇 →Epoch 实测:前沿模型做不出端到端的 AI 研发,看着像做出来的是在刷分