阿里通义放 RecreationWorld:让智能体对着运行中的程序重写一遍,GPT-6 Astra 全过率仅 2.8%
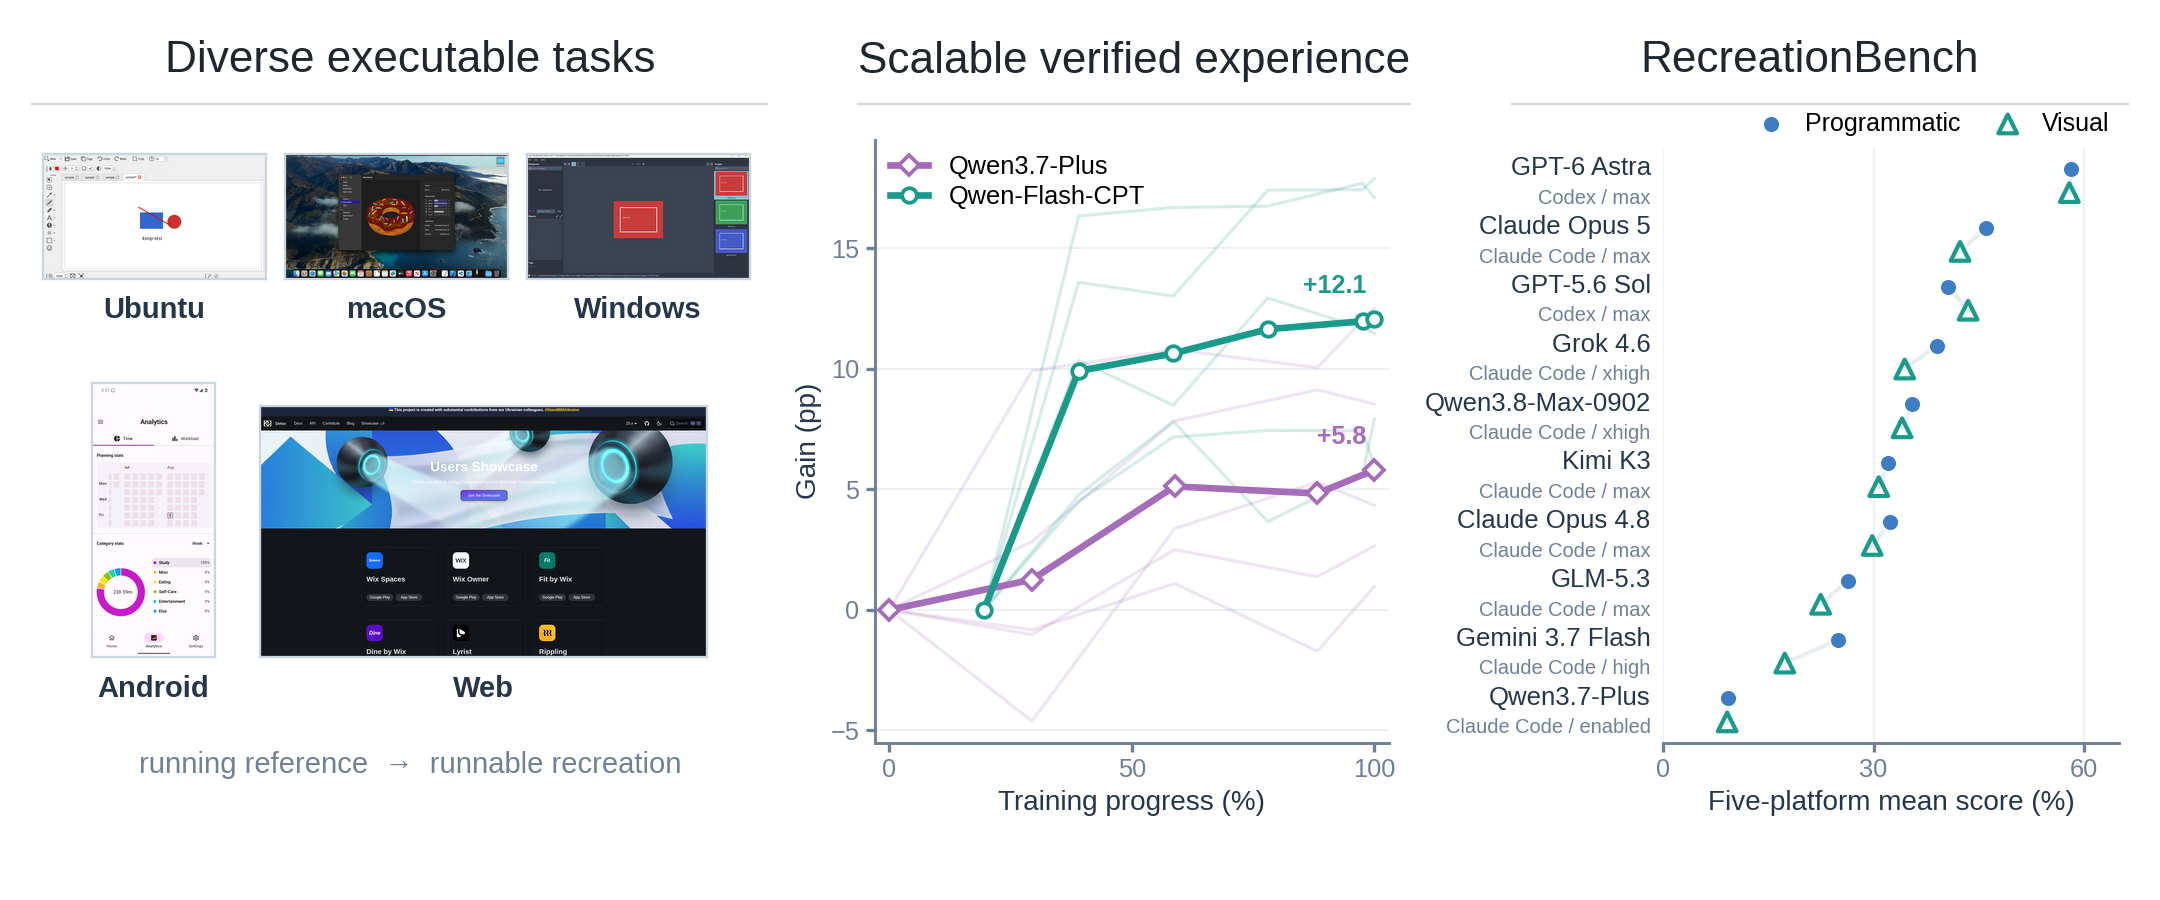
现有的计算机使用智能体沿两条互不相干的线在长:一条走图形界面点按,另一条走代码和命令行写软件。RecreationWorld 的判断是,真实数字工作两样都要,而且必须交替进行——所以它把任务定义成「照着一个正在运行的参考程序,重写出一个行为忠实的实现」,且不给任何规定好的工作流。
关键设计是拿那个真实运行的程序当裁判(execution-grounded):智能体造出来的东西,直接跟参考实现对跑,用隐藏行为测试给出奖励。环境覆盖 Ubuntu、macOS、Windows、Android、Web 五个平台,轨迹用高质量开源应用规模化生成。另有 RecreationBench 250 道留出评测题,程序化断言与视觉断言都先在参考实现上跑通、再经人工复核才冻结。
结论有两个方向。迁移是真的:在五个分布外编码与混合计算机使用基准上普遍提升,且更频繁去验证自己渲染出来的结果。短板也具体:GPT-6 Astra 总体 58.1% 领先,但只有 2.8% 的任务能全过程序化测试——智能体复刻静态界面结构比复刻交互与计算输出可靠得多,生成的应用也比参考实现更小、更单体。权重与数据均未放出,公开的是基准、环境与测试套件。
论文由通义谢志辉等署名,arXiv v1 为 9 月 18 日、v2 为 9 月 21 日,仓库同期在 GitHub 与 Hugging Face、ModelScope 三处放出数据集。
核验记录
arXiv abs 页 citation_date=2026/09/18、citation_online_date=2026/09/21(本版上线日,取此为准),export API published=2026-09-18T17:00:56Z、updated=2026-09-26T21:28:27Z;QwenLM/RecreationWorld 仓库建于 2026-09-18T04:23:07Z(UTC)三个时间戳互证。数字取自 arXiv 摘要:RecreationBench 250 题、GPT-6 Astra 总体 58.1%、全过程序化测试仅 2.8%。未读 PDF 全文,仅读 arXiv 摘要页 47,955 字符。配图 raw.githubusercontent overview.png 裸请求与带 Referer 各测一次均 200/448,164 字节真 PNG。
← 上一篇Linkup 开源 SPARSEUP:149M 稀疏检索模型,BEIR-13 拿 56.4 补齐三架构对照下一篇 →Epoch AI:承认使用 AI 的数学预印本从 4 月的 4% 涨到 8 月的 25%,其中 6% 明确承认 AI 做出实质研究贡献